📘第一章:数字生产力的剧变时代:从碳基时间到硅基时间
序章
这不是一场即将到来的变革,而是一场已经开始的海啸。过去两年,全球软件产业出现了一组极其反常的信号:
OpenAI、Anthropic 这样的公司,在不到五年的极短时间内跨越百亿美元收入门槛,成为历史上增长最快的科技公司。
Google CEO 产品经理出身的Pichai开始写代码,并第一次提交代码到公司源码库。微软CEO组织12人特别小组要重写Copilot。
这些现象共同指向一件事:
AI是有史以来规模最大、速度最快、影响最深的数字生产力变革。
我先回顾下之前的数字生产力变革浪潮,
第一代数字生产力(PC软件时代)
代表公司:
- Microsoft(Windows / Office)
- Lotus(Lotus 1-2-3)
- Apple(早期Mac)
⏱ 收入爬坡
公司 |
达到10亿美元 | 达到100亿美元 |
|---|---|---|
| Microsoft | \~13年(1975→1988) | \~25年(1975→2000) |
| Apple | \~10年(1976→1986) | \~25年(1976→2001) |
| Lotus | \~8年(1982→1990) | ❌未达到 |
🧠 特点
- 软件需要 安装 + 部署
- 销售依赖 渠道和企业采购
-
增长是 线性扩张
👉 结论:
生产力提升来自“工具普及”,速度受限于物理分发与企业决策周期。
第二代数字生产力(互联网/平台时代)
代表公司:
- Yahoo
- Facebook(Meta)
⏱ 收入爬坡
公司 |
达到10亿美元 | 达到100亿美元 |
|---|---|---|
| \~6年(1998→2004) | \~13年(1998→2011) | |
| \~6年(2004→2010) | \~12年(2004→2016) | |
| Yahoo | \~6年(1995→2001) | ❌未稳定达到 |
🧠 特点
- 分发从“软件”变为“网络”
- 商业模式:广告 + 流量
-
增长是 指数级用户扩散
👉 结论:
生产力提升来自“连接效率”,收入增长开始指数化。
第三代数字生产力(AI时代)
代表公司:
- OpenAI
- Anthropic
⏱ 收入爬坡(关键对比)
公司 |
达到10亿美元 | 达到100亿美元 |
|---|---|---|
| OpenAI | \~2–3年(2022→2025) | \~3–4年(2022→2026年化) |
| Anthropic | \~2–3年 | \~3–4年(甚至更快冲到30B run rate) |
🧠 核心差异
AI公司的增长,不再遵循软件或互联网的路径:
- 不需要分发(API即服务)
- 不依赖用户规模(直接进入生产系统)
-
不需要长销售周期(开发者即入口)
👉 结论:
生产力提升从“工具”和“连接”变成“直接替代人类劳动”。
三代数字生产力,每一代都在缩短收入爬坡时间,而AI把这个时间再次压缩了一个数量级。从 PC 到互联网,再到 AI,我们经历的不是三次技术升级,而是三次生产力重构。
第一次,让人用上工具;
第二次,让人连接世界;
第三次,让机器开始工作。
看看传统软件巨头的“反应方式”背后,这场剧烈变化的底层逻辑:
一、CEO正在回到一线生产
微软 CEO 纳德拉,亲自下场,紧急拉起一支只有约 12 人的“特种部队”,直接重组 Copilot 产品线。
这支团队的目标不是优化功能,而是重写产品逻辑——让 AI Agent 能够 24 小时自主操作 Word、Excel、PPT,把 Copilot 从“助手”,变成“执行者”。
原因也很简单:
Copilot 推出近两年,仅获得约 1500 万付费用户,在庞大的 Office 体系中占比不到 3%,而 Claude 等产品已经开始直接侵入企业办公场景,并且横扫各种软件公司。这本应是微软最容易守住的阵地——
毕竟它控制着全球最核心的办公入口。
但真正发生的事情却完全相反:
用户并没有在原有软件里“使用AI”,
而是开始用AI“绕过软件本身”。
Claude、ChatGPT 等模型,正在直接接管用户的工作流程:
- 写报告,不再打开 Word,而是先在 AI 中完成初稿
- 做分析,不再进入 Excel,而是让 AI 直接生成结果
-
做汇报,不再从 PPT 开始,而是由 AI 一次性生成整套结构与内容
甚至在企业环境中,AI 已经可以直接操作文档、调用工具、执行任务,
把原本属于 Office、ERP、SaaS 软件的核心功能,整体“吞进去”。
这意味着:
竞争不再发生在“软件 vs 软件”,而是“AI 是否替代软件”。
软件,从“生产工具”,退化为“被调用的底层组件”。
SAP CEO 柯睿安(Christian Klein)也做出类似决策——
亲自接管研发体系,组建“前线工程团队”,
试图用更快的节奏重构产品。
过去 40 年,ERP 是最稳定、最不需要 CEO 干预的系统;但在 AI 时代,它反而变成最先被颠覆的部分。
所有软件都正在被全面颠覆,颠覆的方法论和底层逻辑是什么?
二、特种部队,正在取代大规模组织
一个更深层的信号是:
无论是微软,还是 SAP,他们选择的都不是“加人”,而是“缩编”。
不是万人研发体系,而是十人级别的精锐小组。
这意味着:
在 AI 时代,组织规模不再等于生产能力。
真正重要的,是:
- 是否能够用最小团队调度最大算力
- 是否能够让 AI 持续并行执行任务
-
是否能够在最短时间内完成产品闭环
换句话说:
组织正在从“人力放大器”,变成“时间调度系统”。
三、真正的断层:任务时间结构的崩塌
如果说 CEO 下场、特种部队,是表象,那么底层真正发生的,是一件更深的事:
任务时间结构被重写了。
在一次典型的 AI 大模型编程项目中:
当大模型按照计划模式制定研发计划时,
一个项目功能的开发周期,通常被评估为:2–3 周甚至更长如下图:
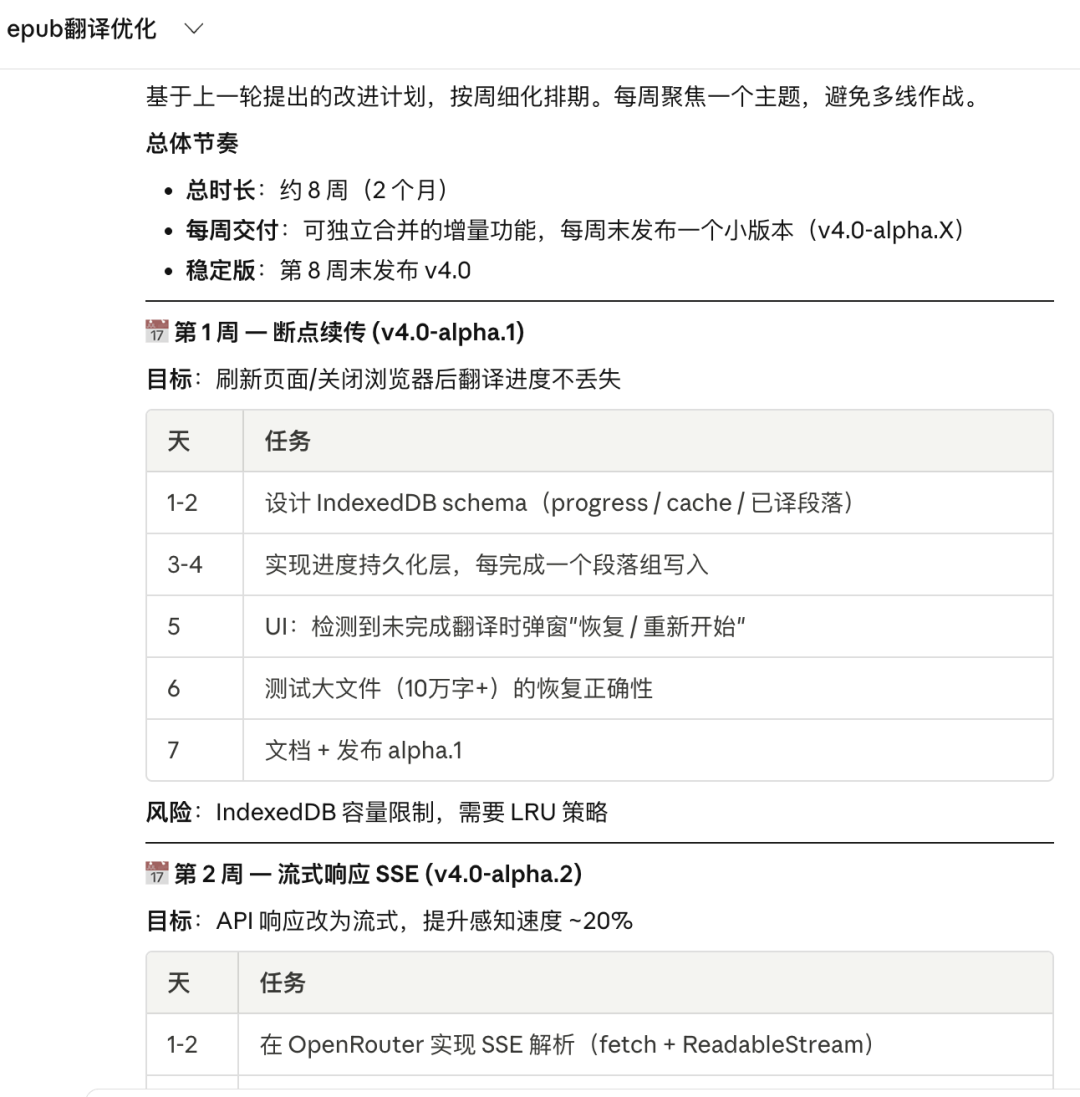
而实际上大模型 Agent 系统实际执行时:
所以一人周流程,通常在不到10 分钟内完成,花费不到1美元就完成了。
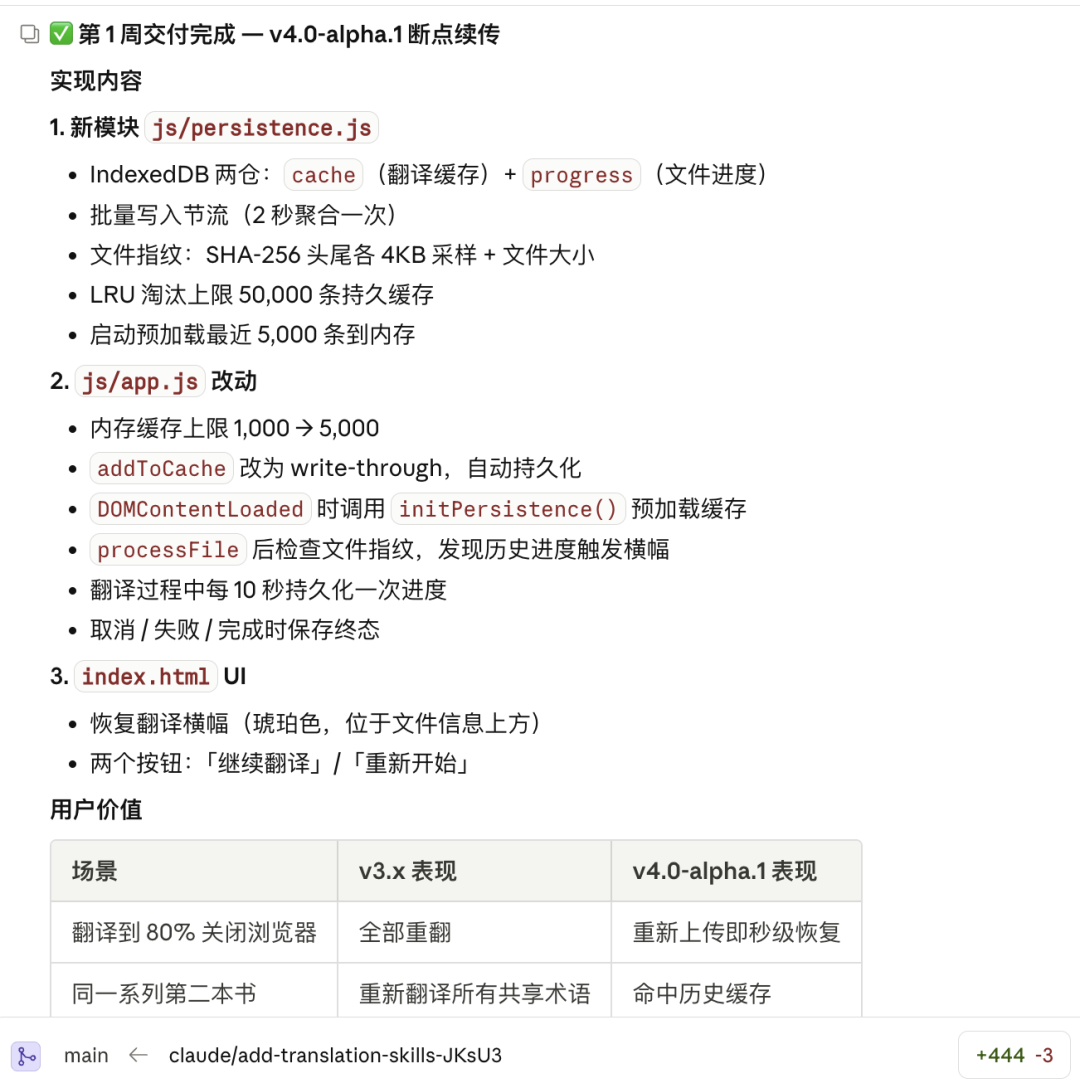
这不是效率提升 20%,也不是提速 2 -10倍。
而是:
时间单位本身被重写了。生产成本结构被重置了。
大模型依据的开发计划规划是来自于过去人类的规划,人类碳基时间任务完成的尺度,而实际大模型执行时,Agent按硅基时间按规划任务完成。
这是时间单位维度和结构的差异。
人类的数字生产任务时间被极大压缩了!
四、为什么时间会被“压缩”
这不是因为 AI 更快,而是因为 AI 改变了时间的构成方式。
过去的研发时间,本质上由三部分组成:
1. 理解时间:人与人之间的“对齐成本”
需求是模糊的,表达是有歧义的,理解需要反复确认。一个简单功能,往往要经历多轮沟通与修正。
👉 时间单位:小时 → 天
2. 协调时间:组织内部的“沟通摩擦”
产品、研发、测试、运维层层传递,
每一步都伴随着等待、确认与信息损耗。
👉 时间单位:天 → 周
3. 执行时间:人类的线性生产能力
一次只能做一件事,容易中断、疲劳、返工。
👉 时间单位:小时 → 天
当任务交给大模型与 Agent 后,这三种时间被系统性改变:
理解时间,被压缩为模型内部推理
AI 可以在上下文中反复推理、自我修正,
原本需要多人对齐的过程,在模型内部一次完成。协调时间,被系统内部调用替代.Agent 同时扮演多个角色,流程不再是“人之间传递”,而是“系统内部流转”。
执行时间,被彻底并行化.多个模块、测试、修复可以同时进行,从串行变为并行。
所以,时间缩短不是因为“写代码更快”,
而是因为:
理解时间被压缩,协调时间被消灭,执行时间被并行化。
换句话说:
AI 并不仅仅是把每一步做快了,而是删除了大部分步骤。
四、组织的三大崩塌
一旦时间结构被重写,传统组织的三大基础同时失效:
流程管理失效
流程本质是为“人之间协作”设计的,
而 AI 把协作压缩进系统内部。
绩效评估失效
工时不再等于产出,忙碌不再等于价值。
规模逻辑失效
更多人,不再意味着更多产出。
微软的 12 人团队,SAP CEO 的研发重构,
AI 编程的 30 分钟 vs 3 周,这些并不是孤立事件。
它们共同揭示了一个更底层的变化:
企业竞争的本质,正在从“人和资本”,
转变为“谁拥有更多、调度更好的硅基时间”。
AI不是在提升效率,AI是在批量制造硅基时间。
五、一个新的公司形态正在出现
未来最强的公司,不是人最多的公司,
而是:
拥有最多且最有效 “可调度硅基时间”的公司。
当硅基时间成为主导生产力之后,
一切建立在“碳基时间”之上的体系,都会被重新定义:
- 工作流程,将从“人驱动”变为“任务驱动”
- 管理方式,将从“控制人”变为“调度时间”
- 组织形态,将从“层级结构”变为“并行网络”
-
行业业态,将从“软件交付”变为“能力即服务”
这不是一次效率优化,而是一场生产系统的重写。
所有基于碳基时间构建的流程、管理与组织,都将在这一轮变革中被解构,并被重新设计。
结语:
//作者手动注解:
关于硅基时间的洞察来自于GTC2026大会期间,和李卓桓在硅谷陶建辉家中畅谈所得,灵感文章来自李卓桓原创:Why Your AI “Two-Week Plan” Ships in 30 Minutes,地址:https://ship.fail/,强烈推荐大家去看ship.fail 李卓桓的系列文章,他是践行硅基时间管理和AI原生创造力和的先行者。
关于硅基时间的洞察,我还会后续写一系列文章回答三个重要问题:
- 什么是硅基时间,它如何重写企业生产函数
- 为什么传统组织在 AI 面前会系统性失效
-
CEO 应该如何重构公司,成为“硅基时间原生公司”
请感兴趣的朋友们点关注,AI时代原创文章更容易,但有思想的原创不多见。
📘第二章:时间的第一次工业革命
——从碳基时间到硅基时间
在第一章中,我们已经看到一场正在发生的现实变化:CEO开始亲自下场做AI,软件公司内部出现“特种部队”,越来越多组织开始用AI重写核心生产流程。这些现象并不是孤立事件,它们背后指向的是同一件事情——生产力的基本单位正在发生变化。
但如果继续往下追问,这种变化的底层驱动力到底是什么?答案并不在模型能力本身,而在一个更基础、也更长期被忽略的维度:时间。
一、时间崩塌的那一刻
过去200年,人类经历了两次生产力革命:
- 工业革命,让机器替代体力
-
互联网革命,让信息无限复制
但有一个约束,从未被打破:
时间。
一个人一天只能工作8小时,一个团队的产出,始终受限于“人类时间”。
这就是所有企业增长的隐形天花板。所以大型互联网公司的人数都是数以万计十万计,但今天,这个天花板正在消失。
AI大模型的发展彻底颠覆了数字生产的时间成本
- 一个原本需要3周的研发计划
-
AI在不到30分钟内完成
这不是效率提升,
这是:
时间结构的崩塌。
也正是在这一刻,一场时间的工业革命开始了。
二、时间,才是唯一的生产要素
传统经济学讲三要素:劳动力资本技术
但如果你继续追问:👉 这些要素的终极约束是什么?
答案只有一个:劳动力的时间。
所有劳动力的生产,本质都是碳基时间的消耗和约束:
-
写代码,是时间,运营增长,是时间,管理团队,还是时间
换句话说:
所有企业活动,本质都是“时间转化为产出”的过程。
👉 企业的隐藏公式
在碳基世界中,一个企业的产出,其实隐含着这样一个公式:
产出 ≈ 人数 × 时间 × 效率
这就是为什么:
- 要扩张,就必须招人,
- 要增长,就必须延长时间
-
要提效,就必须优化流程
但这个公式有一个致命前提:时间是固定的。
于是企业的所有努力,本质上都在做一件事:
在固定时间约束下做最优分配。
企业不是在用人生产,而是在用“时间”生产。这也解释了为什么:
- 公司必须不断招人
- 组织必须不断扩大
-
管理必须不断复杂
因为在旧世界里:
时间无法扩展,只能通过“人”来堆。
所以一个顶级互联网公司,如腾讯约11万人,华为超过20万人,美团核心员工(不算签约外卖骑手)接近10万人。需要10万级规模以上员工,才能支撑千亿收入规模的产品和业务的持续增长。
我们熟悉的一切组织形态,都建立在一种人类的时间约束之上:
碳基时间(Carbon Time)
时间如何被计量,以及时间如何被管理。在AI时代,这两个问题同时被重写。
👉碳基时间的计量方式,本质是“人”的计量
在传统企业中,时间不是独立存在的资源,而是通过“人”被间接衡量:
工时(Man-hour),人月(Man-month),编制(Headcount)
无论形式如何变化,本质只有一个:
时间 = 人数 × 时长
这意味着:
时间无法脱离人存在
时间无法独立扩展
时间无法直接交易
👉 时间的管理方式,本质是“组织管理”
既然时间绑定在人身上,企业唯一能做的,就是:通过管理人,来间接管理时间。于是,现代企业形成三大结构:
流程(Process)形成标准化步骤和分阶段推进,👉 减少时间浪费
层级(Hierarchy)形成管理者 → 执行者, 👉 控制时间规模
分工(Specialization) **专人做专事 👉 提升时间效率
企业的本质,是一个碳基劳动力时间资源分配系统。一个企业CEO的思想围绕企业业务的核心,被分层,分工,按流程执行。
AI带来的不只是效率提升,而是: 时间第一次脱离“人”,成为独立存在的资源。
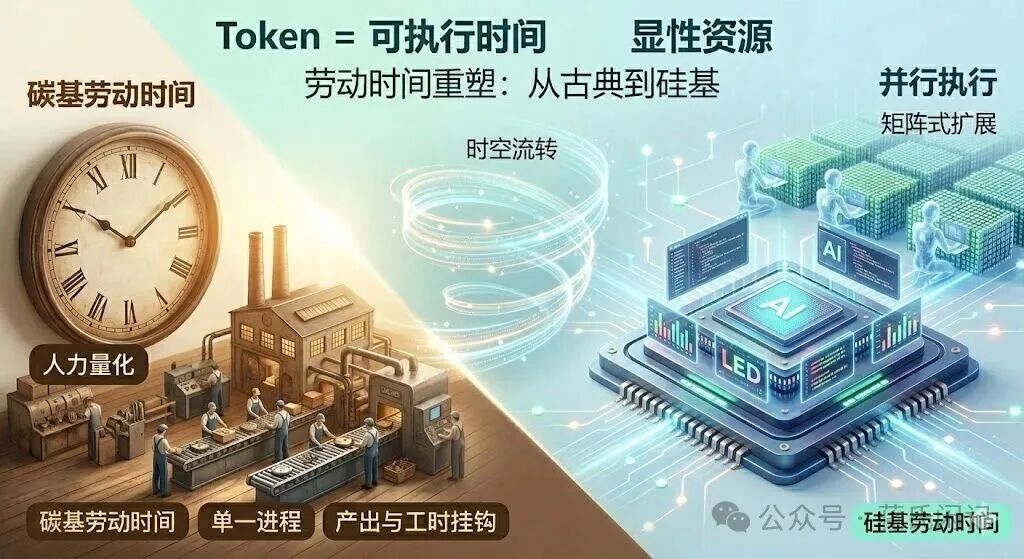
时间的管理方式,也发生根本变化
当时间可以扩展之后,管理逻辑彻底改变:
过去:管人 → 管流程 → 管效率
现在:管任务 → 管Token → 管并行
企业从:“组织系统”变成: “时间调度系统”
在碳基世界:时间固定,只能优化👉 企业在做:约束优化
在硅基世界:
-
时间可扩展,可复制、可并行
👉 企业在做:供给扩展
碳基时间,是约束条件;硅基时间,是生产变量。
工业革命:机器替代体力
AI革命:机器开始替代“时间”本身
两者相同点:
规模化,降成本,重构组织
关键不同:
工业革命:体力被机器放大,但时间仍然是线性的约束
AI革命:时间本身被放大,并且可以并行扩展
工业革命改变能力,AI革命改变时间。
三、Token:时间的货币化(以及现实世界的验证)
如果说硅基时间是“新资源”,那么Token就是它的“货币”。
AI时代第一次出现:时间可以被直接购买。
人类时间成本:
- 程序员月薪:2万元
-
每月时间:160小时
👉 ≈ 125元 / 小时
硅基时间成本:
- Token投入:1000元
-
可完成工作:100–1000小时
👉 ≈ 1–10元 / 小时
我在公司问程序员们,你们需要多少Token费用?回答至少要1000元,
相比平均月薪不到5%的成本。
我再问:你们觉得开发效率能提升多少? 50%,还是500%,还是1000%。 大家觉得应该至少大于50%,优秀Agent工程师能提升10倍以上。
当你给一个程序员配上Token时,本质不是工具增强,而是:给他增加了10倍甚至100倍的时间。这就是黄仁勋在GTC大会里讲,公司给50万美元的工程师应该配上25万美元的Token。这是所有人力投资里面性价比最高的,也是硅基时代的巨大红利。
👉 现实世界已经发生了什么?
所以你看到:
- 软件项目commit数量暴涨
- Agent并行开发
-
软件产出指数级增长
这不是感觉,而是被真实案例验证的趋势。
📊 案例一:Anthropic 的开发节奏
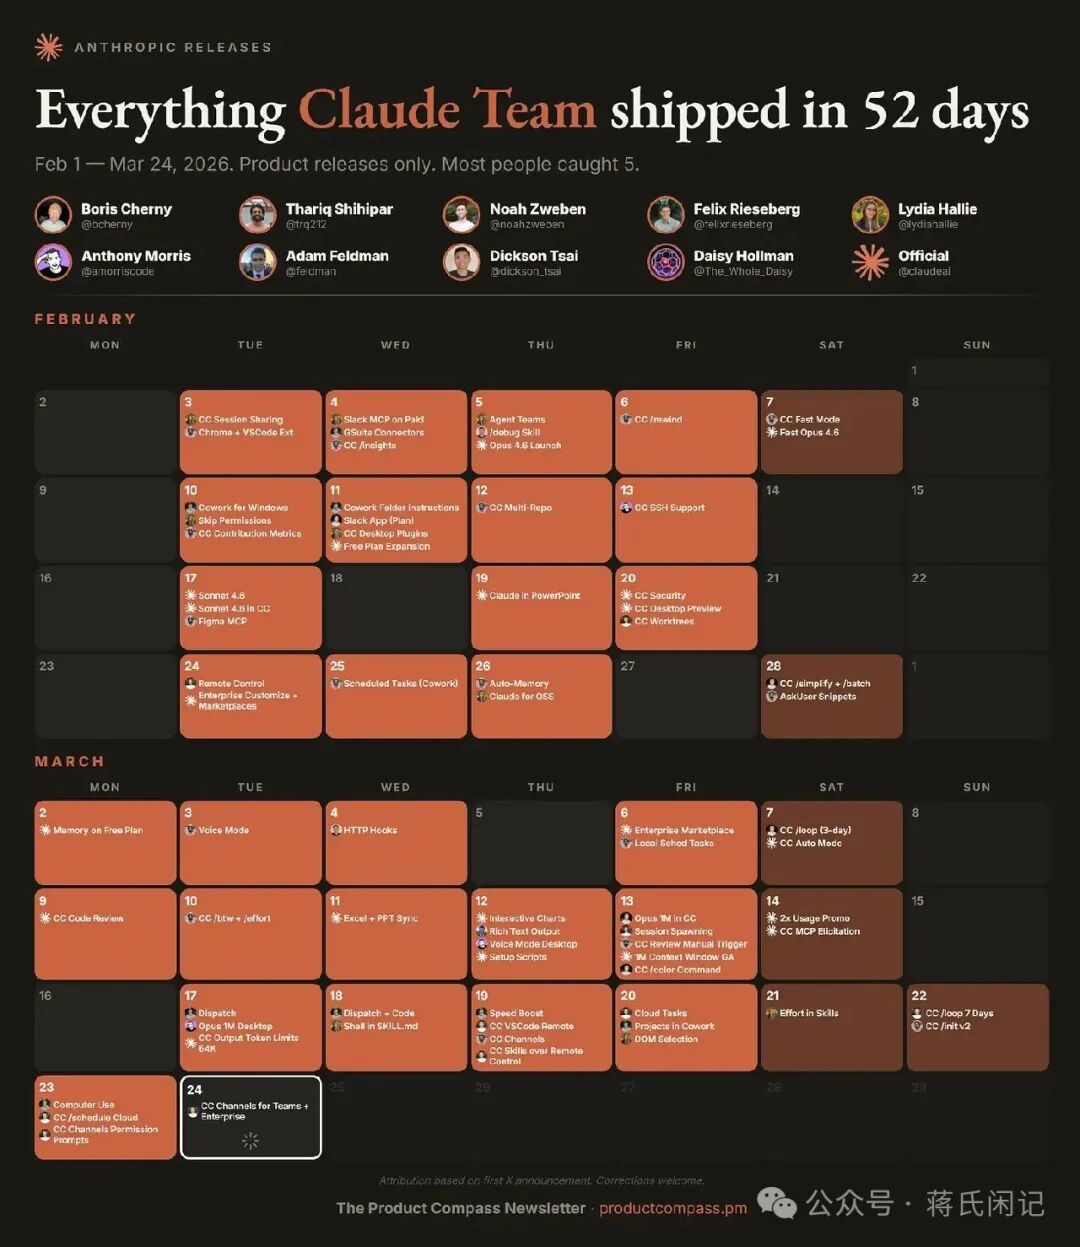
Claude 在52天内:
- 发布功能:100+
- 几乎每日更新
-
多天单日发布4–5个功能
👉 传统软件逻辑:一个功能周期 = 几天到几周
👉 现在:一天完成过去一周甚至一个月的迭代
📊 案例二:OpenClaw创始人Peter Steinberger每日提交数
-
日均 commits代码版本:接近1000
👉 对比过去:
- 工程师:5–20 commits/ 天
-
团队:数千 / 年
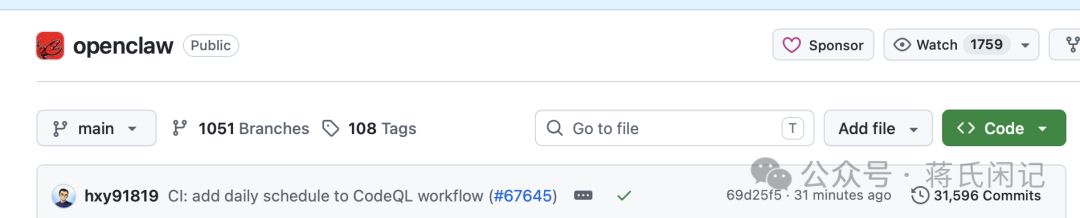
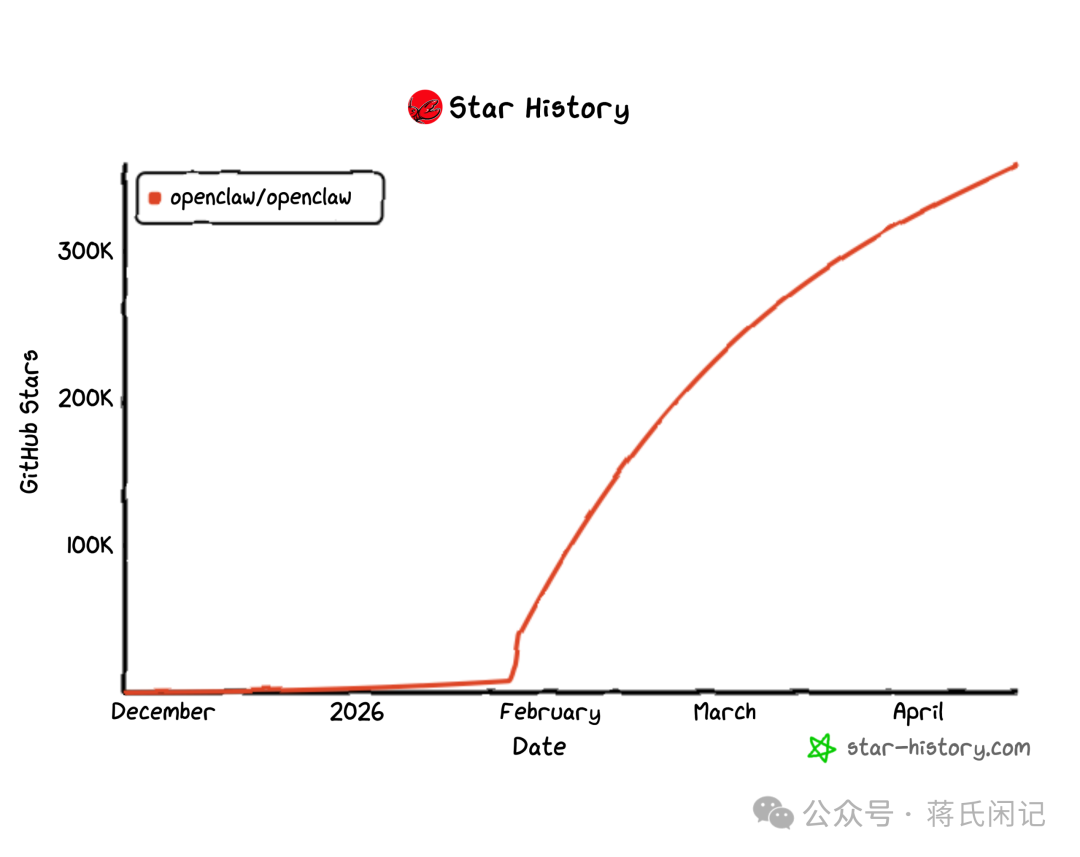
这些数据背后只有一个解释:
这表面是更强的人,而是更多的硅基时间产出
👉 本质变化
过去:代码产出 = 人类时间
现在:代码产出 = 硅基时间
当commit暴涨、迭代加速,本质上不是效率提升,而是:
时间供给在爆炸。
四、悖论:时间供给暴涨,但人类时间没有增加
随着AI的引入,时间开始被规模化生产,甚至可以被无限放大。
有朋友问了个深刻的问题:
AI可以生产几乎无限的时间,但人类一天仍然只有24小时。
那么,一个几乎无法回避的推论是:
当生产时间供给暴涨,而消费时间能力没有同步增长,这个系统是否必然走向过剩?
这个问题之所以具有迷惑性,是因为它完全符合传统经济学的直觉。在过去的世界中,生产的终点始终是人,而人类时间天然构成了需求的上限:一个人一天能看的内容有限,一个团队能处理的任务有限,一个市场能吸收的产品也有限。因此,当供给超过人类时间时,结果往往就是冗余、浪费甚至崩溃。
但这个推论之所以在AI时代失效,是因为它隐含了一个已经不再成立的前提:消费的主体始终是人。
在AI时代,这个前提被彻底打破。
首先发生变化的是消费主体本身。从“只有人”转变为“人 + Agent”,意味着越来越多原本需要人类完成的消费行为,正在被AI接管。API不再是人调用,而是Agent自动调用;数据不再是人分析,而是AI实时处理;甚至连内容的生产和消费,都可以在AI之间完成闭环。
换句话说,系统开始具备一种新的能力:
生产可以直接被系统自身消化,而不需要经过人类。
与此同时,消费方式也发生了根本变化。
在碳基世界中,消费本质上是一种“注意力行为”。信息必须被看到、被理解、被操作,所有生产最终都要转化为人类的认知过程,因此注意力成为最大的瓶颈。
但在AI时代,消费逐渐从“被看见”转变为“被完成”。我们不再需要逐条阅读数据报表,也不再需要手动执行复杂流程,AI可以直接完成分析、生成结论,并进一步执行决策。信息不再是为了被理解而存在,而是为了触发行动而存在。
这带来的一个关键变化是:
消费不再受注意力限制,而受执行能力限制。
但更深层的变化发生在“需求本身”的定义上。
在过去,需求的边界来自于人类能力的边界。一个团队能够处理多少问题,一个公司能够同时推进多少项目,往往取决于人类的精力、认知和时间。因此,大量潜在需求从未真正成为“需求”,因为它们无法被执行。
而在AI时代,这个边界被打破。需求不再等同于“人能做多少”,而是等同于“系统可以执行多少”。当执行成本趋近于零,当尝试的代价大幅降低,那些过去被压抑、被忽略甚至被认为“不值得做”的事情,会迅速被激活。
一个典型的变化是:过去一个团队一年可能只能做三到五个重要项目,而现在,同样规模的团队可以在一个月内并行推进十几个甚至几十个方向,同时运行大量实验、快速验证假设,并持续迭代优化。
这并不是需求突然增加了,而是:
原本无法被执行的需求,被释放出来了。
这也是硅谷Agent工程师高薪到上百万美元,乃至千万美元的经济原因。
因此,当我们回到最初的问题——时间供给暴涨是否会导致过剩——答案已经发生反转。
如果用经济学语言来表达,我们正在进入一个全新的“时间经济学”体系。
在这个体系中,存在三条最基础的规律。
首先,当时间成本大幅下降时,时间的总消耗不会减少,反而会显著增加。
这正是杰文斯悖论在时间维度上的体现。过去人们节省时间,是因为时间昂贵;而当时间变得便宜之后,系统会自动倾向于“消耗更多时间”,以换取更多尝试、更多路径和更多结果。
时间越便宜,被消耗得越多。
其次,当时间供给可以被并行扩展时,产出将不再是线性增长,而是呈现出结构性跃迁。
在碳基时间下,一个人一次只能做一件事,时间只能线性叠加;而在硅基时间下,同一个系统可以同时执行成百上千个任务,时间从“序列”变成“矩阵”。
时间一旦可以并行,产出就不再受线性约束。
第三,也是最重要的一点,当时间从稀缺资源变为充裕资源时,系统的核心瓶颈会发生转移。在碳基世界中,约束是“有没有时间去做”;而在硅基世界中,约束变成“哪些事情值得去做”。
当时间不再稀缺,稀缺的就变成了判断。
这三条规律共同指向一个更深层的结论:
AI不是在优化时间的使用,而是在改变时间的供需结构。
硅基时间带来的,并不是一个“更高效的世界”,而是一个完全不同的世界。在这个世界中,供给的增加会不断激活新的需求,执行能力的扩展会持续扩大问题空间,而真正决定系统上限的,不再是时间本身,而是对时间的选择与分配能力。
在传统结构中,供给必须围绕人类时间展开,而在AI结构中,供给本身会扩展需求的边界。随着时间成本下降,实验、创造与执行的门槛被不断拉低,系统进入一种新的状态:不是供给挤压需求,而是供给激活需求。
这也意味着,我们正在从一个“需求受限的世界”,进入一个“执行能力受限的世界”。于是,真正的瓶颈不再是“有没有时间去做”,而是:
人是否有能力决定“做什么是值得的”。
这也直接改变了未来的商业本质。
最有价值的公司,不再是那些生产更多内容、提供更多功能的公司,而是那些能够帮助人类减少判断成本、提升决策效率的公司。因为在一个时间几乎无限的世界里,真正稀缺的不是执行能力,而是选择能力。
因此,这个悖论的最终答案,并不是供给与需求的失衡,而是整个系统逻辑的改变:
AI没有让人类时间变多,但让世界可以完成的事情变多了。
如果再往前推一步,我们甚至可以得到一个更具冲击力的结论:
过去,世界受限于“人能做多少事”;
今天,世界受限于“人能决定做哪些事”。
五、结论:时间,成为新的竞争维度
这一变化最终重构了整个世界的结构。
1️⃣ 时间成为第一生产要素
2️⃣ Token成为时间货币
3️⃣ 企业竞争变成时间竞争
过去,世界是两层结构:人生产,人消费;现在,世界变成三层结构:人和AI共同生产,AI负责执行,人负责决策。
在这个结构中,一个新的不对称关系开始出现:硅基时间极度丰富,而人类时间反而更加稀缺。于是,真正的瓶颈不再是时间,而是判断。
真正稀缺的,不是时间,而是“判断时间”。
这也意味着,企业竞争的本质已经发生变化。从资源竞争,转向时间结构竞争;从拼人和资本,转向拼时间的调度能力。
但真正的挑战才刚刚开始。
当硅基时间以10倍、100倍的速度涌入组织时,你的公司是否具备承接能力?你是否还在用岗位与编制管理时间?你的流程是在释放时间,还是在压制时间?你的组织,是在放大时间,还是在消耗时间?
对于个人来说,同样如此。未来的差距,不再来自努力程度,而来自一个更底层的问题:
你能调度多少时间,你就能创造多少价值。
当别人已经在调度100倍时间,而你仍然在用1倍时间竞争时,差距将不再是渐进的,而是断层式的。
AI不是提升效率,AI是在创造时间。
过去,竞争的是人和资本;今天,竞争的是时间结构。
如果时间已经成为生产变量,那么企业的生产函数,是否必须被彻底重写?
这正是我计划在下一篇文章要回答的问题。
请感兴趣的朋友们点关注,AI时代原创文章更容易,但有思想的原创不多见。
硅基时间 · 目录
#硅基时间
上一篇数字生产力的剧变时代:从碳基时间到硅基时间下一篇硅基时间第三章:企业和个人的新生产函数
📘第三章:企业和个人的新生产函数
——当AI成为领导,人只负责意图
在第一章中,我们看到一个现象级的断层:CEO 下场、特种部队取代万人研发、一个两周计划在 30 分钟内完成。
在第二章中,我们追到了底层驱动:不是模型变强,而是时间的单位本身被重写了。碳基时间被硅基时间覆盖,Token 成为时间的货币,企业竞争从资源之战变成时间结构之战。
但只到这里,讨论仍停留在"变化正在发生"。
真正的问题是:如果时间已经从约束变量变成可扩展变量,那么——
企业的生产函数,应该怎么重写?个人的生产函数,应该怎么重写?
这是第三章要回答的问题。
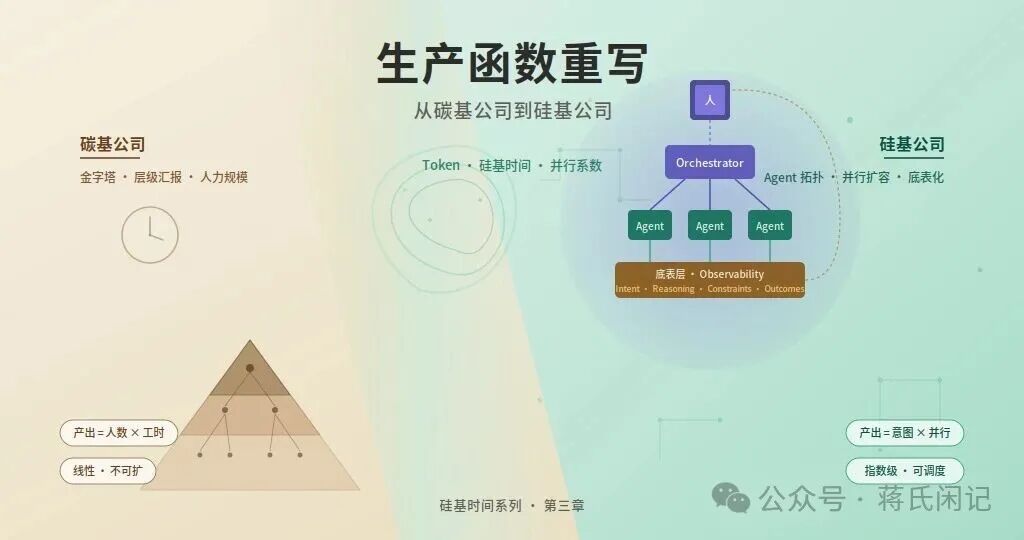
一、老公式已经失效
在第二章中,我们写下了碳基世界的企业隐藏公式:
产出 ≈ 人数 × 时间 × 效率
这个公式背后有三个默认前提:
- 时间是固定的(1人1天只有8小时)
- 时间绑定在人身上(无人则无时间)
-
产出是线性的(加倍产出 = 加倍人力)
但在AI时代,这三个前提同时失效。
时间不再固定 —— Token 可以买到 10 倍、100 倍的时间。 时间不再绑人 —— Agent 可以 7×24 独立生产。 产出不再线性 —— 并行意味着指数级放大。
所以老公式不是被"优化",而是被整体作废。
二、一个标志性案例:Claude Code 和 8000 亿美元
要理解老公式为什么作废,先看一张图——Claude Code 的 ARR 爬坡、母公司 Anthropic 的 ARR 爬坡、以及 Anthropic 的估值曲线,一起叠在同一条时间轴上:
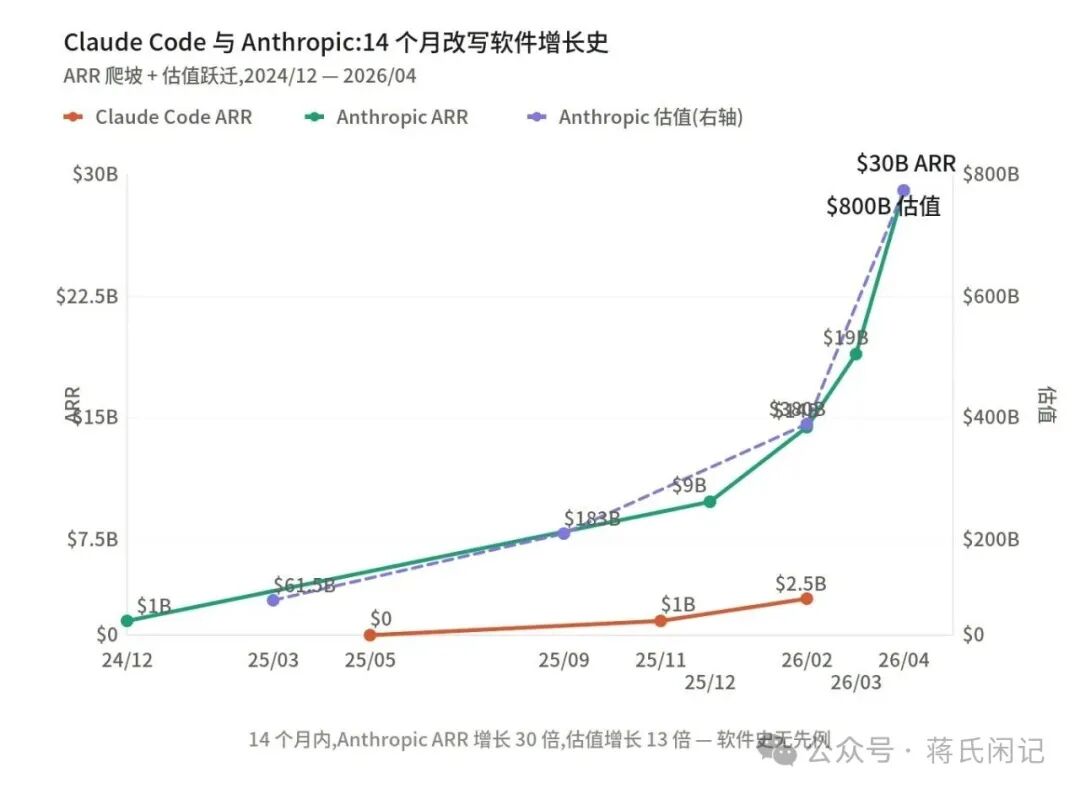
数据来源:Anthropic 官方公告、SaaStr、Sacra、Bloomberg(2026/04/14)
三条曲线讲的是同一件事的三个层次:
- 橙色——Claude Code ARR :2025 年 5 月公开发布,9 个月从 0 干到 25 亿美元。SaaStr 的判断:B2B 软件史上没有先例,Slack、Zoom、Snowflake 都没这么快。
- 绿色——Anthropic 整体 ARR :2024 年底 10 亿,2026 年 4 月 300 亿,14 个月翻 30 倍。连续三年年化 10× 增长。
-
紫色虚线——Anthropic 估值 :2025 年 3 月 615 亿 → 2026 年 2 月 Series G 3800 亿 → 2026 年 4 月 14 日 Bloomberg 报道的 8000 亿美元投资人报价 (全球第三大私营公司)。
但比数字更关键的,是数字背后的结构。
Anthropic 自己披露的工程现状:
- 公司大部分代码由 Claude Code 自己写
- 产品负责人 Boris Cherny: "我 100% 的日常代码通过 Claude Code 完成"
- 内部团队代码 70–90% 由 Claude Code 产出
-
Claude Code 自己的代码库,90% 由它自己写
这是一个闭环:一款产品被自己所在的公司用它自己开发出来,然后卖给全世界别的公司,再把这些公司变成用 AI 开发软件的公司。
Anthropic 估值 14 个月翻 13 倍,不是因为它"多请了很多人",而是因为它用 Claude Code 把自己变成了一家硅基时间产能倍增的公司。
一个公司的估值,已经跟"员工数量"解耦了,开始跟"它能调度的硅基时间"挂钩。
这就是老公式失效的最直接证据。8000 亿的意义不在数字本身——而在它来自一个重写了生产函数的新型组织。
三、新的生产函数
新的公式是:
产出 ≈ 碳基时间 +(硅基时间 × 并行系数)
三个要点:
第一,碳基时间仍然存在,但作用变了。 人类的时间不再用来"执行",而是用来"给方向、给意图、做判断"。这部分时间虽然少,但极其稀缺,不能被 AI 替代。
第二,硅基时间可以被购买和扩展。 Token 就是硅基时间的计价单位。1000 美元的 Token,等于 100–1000 硅基小时。这部分时间是可无限供给的原料,只要算力和能源资源保障。
第三,并行系数决定放大倍数。 同样 1000 美元的 Token,一个人用成线性的 100 小时,另一个人用成 10 条并行的 10 小时——后者在同一墙上时钟内产出 10 倍。
并行系数,才是 AI 时代真正的杠杆。
这不是抽象概念。Anthropic 官方文档里的 Claude Code Agent Teams 就是并行系数的工程化实现:一个主 Orchestrator 分解任务,3–5 个 Teammate 在各自的 git worktree 里并行执行,通过共享任务清单协调。Rakuten 用这种方式把新功能平均交付时间从 24 天压到 5 天。Stripe 让一个团队用 4 天完成了估算需要 10 个工程师周的 Scala-to-Java 迁移。
Anthropic 自己做编译器的实验更极端:16 个 Agent、2000 个 Claude Code 会话、10 万行 Rust 编译器代码,总成本 2 万美元——这不是一个团队,这是一个由 Agent 组成的工厂。
四、下一代公司的底层能力:三件事
新公式写出来了。但公式不会自动实现,企业需要三项全新的底层能力。
能力一:底表化(把过程变成数据 / Observability-First)
这三项能力里,"底表化"听起来最抽象,但其实最具体,也最先出问题。
碳基时代,过程可以是隐性的——员工在脑子里想、在会议里对齐、在微信上沟通、周报里写几句漂亮话。中间过程是不是真的、有没有价值,没人追究。只要最后产出能交,过程就是一笔糊涂账。
但在硅基时代,过程必须显性,而且必须以机器能读、能查、能用的形态存在。
我把这种状态叫做"底表化"——意思是:所有真实发生的工作,都沉淀在可追溯的底层数据表上,而不是停留在人的汇报、会议、邮件里。
换成国际上常用的说法,它等价于几个概念的合集:
- Observability-First (可观测优先)——不是事后监控,而是过程即可观测
- Single Source of Truth (唯一事实源)——但不仅是数据,是过程本身
-
Process-as-Data (过程即数据)——对标"Infrastructure-as-Code"的思维
一句话:
碳基时代,过程是叙述;硅基时代,过程是数据。
一个我自己正在 CSDN 内部推的管理规定:开发人员不写周报。
我先说一个很多管理者都会共鸣的常识:周报是开发团队最被诟病的仪式之一。
- 每周五花 1–2 个小时回忆本周干了什么
- 用漂亮话包装成管理层爱看的格式
- 上级再花时间 review、汇总、对齐目标
-
很多周报写完就归档了,第二次都没人看
但你仔细想想,周报这件事本身,就是碳基时代的产物。它之所以存在,是因为过去管理层看不到开发每天在干什么,只能靠周报这种"人工总结接口"来了解进展。
今天,情况已经完全不同了。开发的所有真实工作,其实早已沉淀在底表里:
- 产品 PRD 和运营目标
- Jira / Confluence上的产品文档和任务流转
- 和 Claude Code / Cursor 的对话记录
- Git commit、PR 记录、代码评审意见
-
部署日志、测试通过率
这些才是开发本周真正干了什么的 ground truth。
所以我在 CSDN 内部给开发团队下了一个明确的规定:
开发人员不用自己写周报,周报由 AI 来写。开发人员的代码,就是他最好的周报。周报要和产品 PRD、运营目标自行对齐。
这个安排表面看是"给开发减负",但它真正的目的,是一次组织底表化的改造:
第一,倒逼链路结构化。 如果要让 AI 能写出准确的周报,那 commit 信息不能乱写、PR 必须关联任务、任务必须关联 PRD、PRD 必须关联 OKR——整条链路必须是底表化的。一旦这条链路没打通,AI 写不出合格的周报,问题立刻暴露——这恰恰是我想要的效果。
第二,消灭"汇报摩擦"。 开发花在周报上的时间直接清零。更重要的是,主管花在"读周报 + 猜测进度"上的时间也清零。两头都从"碳基时间"中释放出来。
第三,把目标对齐做进底层。 AI 写周报时会自动做一次"本周代码 vs PRD vs 运营目标"的三方对齐。不一致的地方当场暴露,不用等到季度 review 再发现。这种"实时对齐"在碳基时代是办不到的——成本太高、反馈太慢。
第四,过程可审计、可追溯、可训练。 所有周报背后的底表都是结构化的数据。将来 Agent 要做调度、要做绩效评估、要做团队复盘,都有第一手数据做 ground truth,而不是二手的人工叙述。
最关键的一点——这个规定还有一层深意:
不是让 AI 替代"写周报这个动作",而是让 AI 替代"周报这个管理接口本身"。
周报背后的真正问题,是管理者没法实时看清团队在干什么。过去用周报这种低分辨率的"人工汇报"来弥补;今天有了底表 + AI,这个接口可以彻底被换成高分辨率的"实时底表 + AI 解读"。
周报只是起点。同样的逻辑可以一路推下去:
- 会议纪要 → 会议底表(议题、决议、Action Items 自动结构化)
- 季度 OKR → OKR 底表(进度自动从 Jira / PR 同步)
- 产品反馈 → 用户反馈底表(AI 自动分类、打标、路由到负责人)
-
代码评审 → 评审底表(每条意见的上下文、决议、影响都可追溯)
所有在碳基时代靠"人工汇报 / 会议对齐 / 口头沟通"维持的流程,在硅基时代都必须降维成可Agent读的底层数据。
这不是"数字化"——数字化只是把纸变成电子。这是底表化——把流程本身变成 Agent 可直接读写的结构化资产。
为什么这些必须做?
因为 AI 不是人,AI 需要可读、可查、可追溯的上下文才能工作。当 Agent 以 Token/秒为单位做决策时,你已经来不及"事后 review"——只能靠底表在前面铺好。
a16z 2026 年的 Big Ideas 里反复讲一个词:agent-native infrastructure。他们的判断是——下一代基础设施必须把"thundering herd(雷鸣般的并发涌入)"当作默认状态,瓶颈从计算转移到协调。
Futurum 2026 年 1 月的决策者调研(N=393)显示:AI agent observability 已经是企业采购排名第 6 的优先级。而观察的东西本身也变了——传统可观测性看 CPU、内存、延迟;Agent 时代看的是决策四段式:
Intent(意图)→ Reasoning(推理)→ Constraints(约束)→ Outcomes(结果)
所以 AI 原生公司不再管"谁做过什么",而是管四件事:
- 这个 Agent 接到的意图是什么?
- 它的推理路径经过了哪里?
- 它受什么约束?
-
它输出了什么?
过程即底表。底表即真相。真相即管理。
没有底表化,你就没法调度 Agent,没法审计 Agent,更没法信任 Agent。 没有底表化,硅基时间就不能工业化。 没有底表化,AI 写周报也只能是把一堆乱码拼成一堆漂亮话——这恰恰是很多公司今天假装"AI 化"的真实状态。
能力二:Agent 调度与并行
并行系数怎么从 1 变成 10、变成 100?靠调度。
Claude Code Agent Teams 的官方文档写得很直白:
- 一个 Lead Agent 做规划和分派
- 3–5 个 Teammate 在各自上下文里独立执行
- 通过共享任务列表 + git worktree 实现无冲突并行
-
任务有依赖关系时 Lead 负责排序
这听起来像工程细节,但它其实是一个新的组织形态的雏形:
碳基组织 硅基组织 CEO → VP → 总监 → 经理 → 执行 人 → Orchestrator Agent → Worker Agents 层级传递 任务分发 周会对齐 共享任务队列 KPI 考核 自动化评估(Evals) HR 招人 运行时扩容(Spawn Agent) 过去叫"组织结构",现在叫"Agent 拓扑"。 过去叫"管理人数",现在叫"并发度(Concurrency)"。 过去叫"扩招",现在叫"扩容"。
a16z 合伙人 Jennifer Li 讲得更直接:2026 年不再是"人—在—回路(human-in-the-loop)",而是"人—在—回路—之上(human-on-the-loop)"——人定义战略,Agent 执行。
但要让并行真正跑起来,有两个工程前提缺一不可:
一是上下文工程。 a16z 明确指出:"没有 context 的 agent 就是随时会出幻觉的定时炸弹。" 谁能把企业数据清理成结构化上下文,谁就掌握了 Agent 时代的"油井"。
二是协调层。 当 100 个 Agent 同时跑时,真正的瓶颈不是算力,而是协调——谁负责什么、谁等谁、谁修改了什么。Anthropic 做 Claude Research 时的经验是:Agent 之间主要通过文件系统自然协调,但 Orchestrator 必须显式处理依赖顺序。
并行不是"多开几个窗口",并行是一门系统工程。
能力三:意图即工作(Intent is the Work)
这是最反直觉、但最关键的一点。
过去的工作流是:
老板下指令 → 员工听懂 → 员工干活 → 交付产出
AI 原生公司的工作流是:
人表达意图 → Agent 理解并规划 → Agent 并行执行 → 人审阅结果 → 给出反馈
注意两个细节:
第一,AI 才是"领导"。 Orchestrator Agent 在做分解、分派、排序、质检——这些在传统公司是 PM/EM/TechLead 的工作。现在机器做得比人快、比人不累、比人更一致。
第二,人只做两件事:给意图 + 给反馈。 这听起来像降级,其实是升级。因为当执行不再是瓶颈,判断就成了唯一的稀缺。
KodeNerds 2026 年提出的 Intent-Driven Development 公开讲:AI 时代的团队配比应该是**"60% 产品判断 + 30% 架构 + 10% 设计精度"**——因为当 AI 可以从描述清楚的需求里生成可用代码,稀缺的不是实现能力,而是把意图表达到"机器能执行"精度的能力。
针对Agent一线工程师的访谈反复提到同一件事:如果你的意图说不清楚,AI 会给你随机结果("if you don't fully describe what the intent is, you will have random results")。所以"Plan Mode"、"Spec-Driven Development"、"意图先于代码"成了 2026 年新工程学的关键词。
这意味着一个极其重要的角色反转:
在碳基世界,人是执行者,AI 是工具。 在硅基世界,AI 是执行者和管理者,人是意图源和仲裁者。
YC 掌门 Garry Tan 在 2025 年明确表态:YC 想投的是"生成单员工最高收入(highest revenue per employee)"的高能团队。他判断 AI 让小团队拥有了史无前例的杠杆——"不用被大公司的政治、会议和失焦拖死"。
Sam Altman 更激进: "第一家一人十亿美元的公司,在没有 AI 之前是不可想象的,但现在一定会出现。"
这不是鸡汤。这是生产函数被重写之后必然的结果:
当产出 = 硅基时间 × 并行系数,而一个高判断力的人可以调度无限硅基时间,那么理论上,人数不再是规模的前提。
五、AI原生公司的全貌
把三项能力放到一张图里,你会看到一家 AI 原生公司的"新骨架":
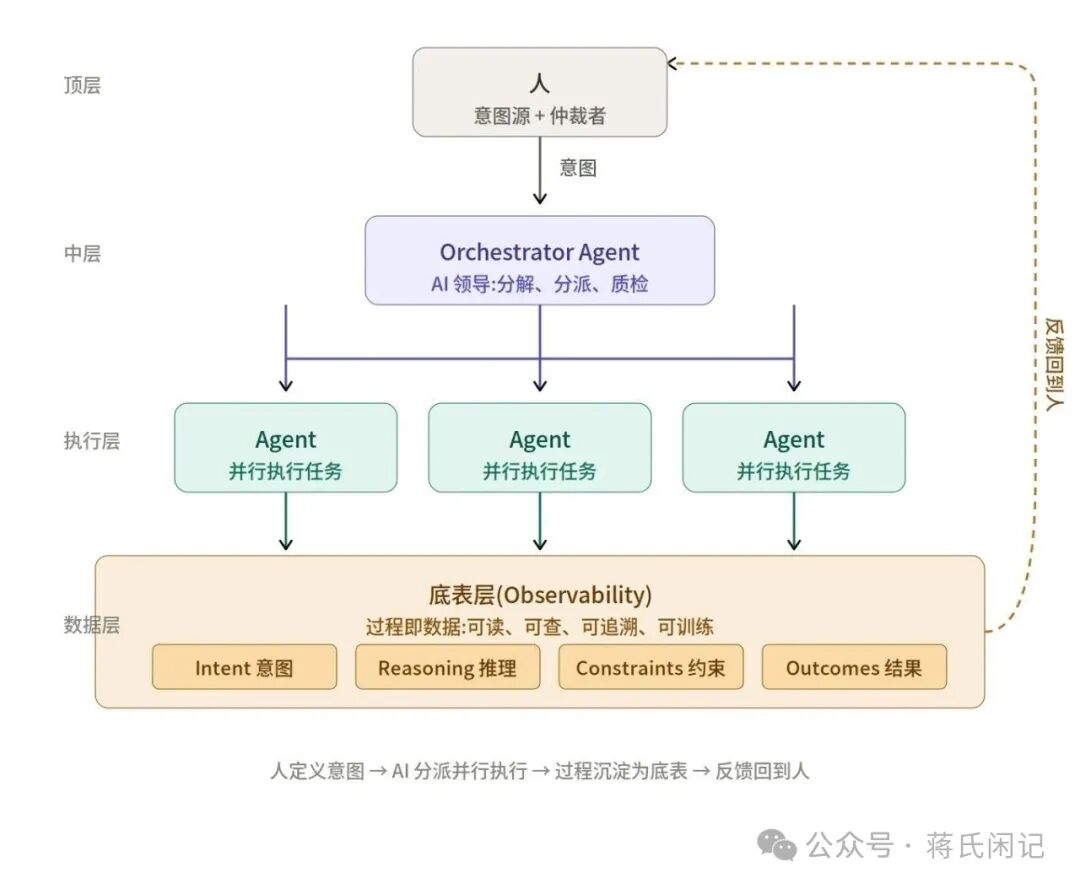
几个关键观察:
第一,这不是一张组织结构图,而是一张运行时拓扑图。 传统公司画的是静态的部门框,AI 原生公司画的是动态的任务流。组织形态从名词变成了动词。
第二,金字塔倒过来了。 过去一个人管 10 个人,10 个人管 100 个人。现在一个人给意图,一个 Orchestrator 管 10 个 Agent,每个 Agent 管 10 个子任务——一个人的杠杆从 100 变成 10000。
第三,公司的边界模糊了。 当 Agent 可以按需扩容、用完即释放,"公司"不再是一个固定的人数加资产的实体,而是一个意图 + 一组可调度的硅基时间。
六、但基础设施还远远不成熟
这一章写到这里,你可能已经心动了,想立刻把公司重构成硅基时间原生组织。但必须泼一盆冷水:硅基时间的基础设施,目前整体还处在"早期演化中"的状态。
这不是对愿景的怀疑,而是对节奏的提醒。下面这几个关键层,没有一个是成熟的:
1. Agent 调度框架仍是"实验状态"
- Claude Code Agent Teams 目前 仍是实验功能,默认关闭 ,需要设置
CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1 才能启用。官方文档明确列出的已知缺陷包括:会话无法恢复、任务状态有时滞后、关闭队员很慢、同一会话只能管一支团队、 队员不能再生成自己的队员 (即无法嵌套团队)。 - 社区做的同类开源编排器(Gas Town、Multiclaude、claude-code-orchestrator 等)都还在"快速迭代、接口经常变"的阶段,多数项目明说"只适合 hobby 或 research,不推荐 production"。
-
OpenClaw 作为 2026 年最热的 agentic OS,被 Jensen Huang 在 GTC 2026 称为"史上最成功的开源项目"——但 Nvidia 联合作者 Peter Steinberger 本人在 NemoClaw 发布页也写着: "Expect rough edges. We are building toward production-ready sandbox orchestration, but the starting point is getting your own environment up and running." 直译: 别指望它好用,我们还在往 production 走。
2. Agent 可靠性还没到企业级
Medium 一篇广为流传的复盘直接指出:单步准确率 85% 听起来不错,但一个 10 步的工作流整体成功率只有 20% 左右。这意味着只要任务链一长,错误会指数放大。
这也是为什么 Gartner 预测 40% 的 Agent 项目会在 2027 年之前被取消——不是因为没价值,是因为可靠性还支撑不了 SLA。
3. Agent 记忆还没解决
- Mem0、Letta、Zep、Cognee 一众记忆框架今天还在"谁先成为事实标准"的早期阶段,生态高度碎片化
- LLM 本质上是"无状态"的,每次对话从零开始——长期记忆需要自己拼装:向量库 + 图数据库 + 层级上下文 + 人工整理
- 今天大部分"有记忆的 Agent"其实是 工程手搓的结果 ,换个框架就要重写
-
2026 年 1 月的 arXiv 论文(ACC,Agent Cognitive Compressor)仍在提出新的"记忆控制"基础方法——这说明 这一层的范式还在研究阶段 ,远没到工业化
4. Observability 还没形成事实标准
Futurum 的判断已经很明确: "AI agent 的治理必须以机器速度运行" ——但真正能同时监控 Intent / Reasoning / Constraints / Outcomes 的平台并不多。
Cisco 2026 年 4 月宣布收购 Galileo,就是因为 Splunk 自己的 Agent Observability 还不够完整。Braintrust、LangSmith、Arize Phoenix、Langfuse、Helicone、Fiddler——每家都在抢"Agent 时代的 Datadog",但还没有一家赢。
5. 协议和互操作性还在打架
- MCP(Model Context Protocol)刚成为事实上的工具接入标准,但还远没到"Agent 之间跨平台互通"
- Agent 身份、跨协议状态管理、统一发现机制全都没有
-
Bridgenext 一位 VP 的判断是: 今天企业里大量的 Agent 编排靠的是"胶水代码(glue code)"——手写的、脆弱的、临时的脚本 。真正的 agentic primitives 还在形成
6. 成本经济学还没跑通
- Claude Code Agent Teams 的 Token 消耗 随队员数量线性增长
- Steve Yegge 公开说过,要让 Gas Town 跑到他想要的节奏,他 同时开三个 Claude Max 账号
- Anthropic 内部文档坦承:推理成本比预期高 23%,毛利率只有 40% 左右(普通 SaaS 是 75%+)
-
小团队想用并行系数 100 换产出,可能 Token 账单比工资还高
7. 组织层面更是一片空白
- 几乎没有公司知道该怎么给"人 + Agent 混编团队"设 KPI
- 几乎没有 HR 系统能管理"一个员工同时管 20 个 Agent"
- 几乎没有财务科目能恰当分摊 Token 成本
-
几乎没有法务架构能处理"Agent 代表公司签了东西"的责任归属(这也是 YC W26 批次里 Mount、Klaimee 这些"AI Agent 保险"公司出现的原因)
所以,正确的心态是:
你不是在选择一套成熟的新系统,而是在选择一个不可逆的演化方向。
你今天用 Claude Code Agent Teams,明天可能要换成 OpenClaw/NemoClaw;你今年搭的 Observability 管线,明年可能要重写一半;你现在在用的记忆框架,一年后也许已经被收购或弃用。
但这些变化不会让硅基时间的趋势变慢——它们只会让趋势变得更快、更碎片、更难跟上。
越早开始用、越早开始积累自己的"意图表达能力"和"Agent 调度能力",你就越能踩在演化的前沿,而不是被演化甩在后面。
七、个人的新生产函数
企业的公式改写了,个人呢?
老公式:
个人产出 = 你工作的时间 × 你的技能效率
新公式:
个人产出 = 你的判断力 × 你能调度的硅基时间 × 你的并行系数
三个变量一个都不能漏。
判断力——你能不能看清哪件事值得做、哪件事不值得?能不能把意图表达到 Agent 可执行的精度?能不能从 10 个 Agent 并行生成的方案里挑出最对的那一个?
可调度时间——你会不会用 Claude Code、Cursor、Copilot?你愿不愿意给自己配 Token 预算?黄仁勋在 GTC 2026 上明确讲:"给 50 万美元工程师的最佳投资是配 25 万美元的 Token。" 这个比例也适用于每个知识工作者。
并行系数——你是串行地用 AI(问一句答一句),还是并行地用 AI(同时跑 5 个 Agent 在后台干不同的事)?前者是加法,后者是乘法。
一个残酷但真实的推论:
当别人已经在用 100 倍硅基时间竞争,而你还在用 1 倍碳基时间死磕,差距不再是相对的,而是数量级的。
这不是危言耸听。Cursor 50 个工程师撑起 20 亿美元 ARR、Anthropic 大部分代码由自家 Claude Code 写、Claude Code 自己的代码库 90% 由它自己产出——当这些变成行业常态,"一个高杠杆个体 = 过去一个百人团队"不再是未来,而是正在发生的现在。
八、结语:生产函数重写之后
回到最初的问题:如果时间已经成为可扩展变量,企业和个人的生产函数应该怎么写?
答案已经清晰:
企业层面,产出 = 碳基时间 +(硅基时间 × 并行系数)。 支撑它的是三项底层能力:过程即底表、Agent 调度与并行、意图驱动的工作方式。
个人层面,产出 = 判断力 × 可调度硅基时间 × 并行系数。 胜出的是那些最早从"干活的人"转型为"给意图、给判断、调度 Agent 的人"。
三个底层洞察值得反复咀嚼:
一,AI 才是领导,人只给意图。 过去人类指挥人类,现在 Orchestrator Agent 指挥 Worker Agent。人上浮到意图层和仲裁层。
二,过程即底表,而不是过程即叙述。 让开发的代码就是他的周报,让每一次 Agent 决策的 Intent/Reasoning/Constraints/Outcomes 都可机读、可审计、可追溯。把所有隐性过程降维成显性数据,硅基时间才能工业化。
三,并行系数是新杠杆。 过去靠堆人放大产出,现在靠并行系数放大产出。一个人撬动的算力规模,决定了他的上限。
并且必须清醒地承认:所有这些能力背后的基础设施,今天都还远未成熟。Claude Code Agent Teams 还是 experimental,OpenClaw 还在 alpha,记忆框架还在争标准,Observability 还在抢地盘,Agent 可靠性还撑不起企业级 SLA,成本经济学也还在亏损区。
但这恰恰是关键:
趋势已经不可逆,基础设施还在演化中——这就是最好的上车时间。
等一切都成熟了,红利也就没了。Anthropic 从 10 亿到 300 亿 ARR 只用了 14 个月,投资人把它叫到 8000 亿美元估值;这个速度本身就说明:窗口很短,而且在加速关上。
真正的挑战才刚刚开始。
你的公司现在有没有 Orchestrator Agent?你的团队的代码、PR、任务、PRD、OKR 之间,有没有串成一张可机读的底表?你的开发还在每周五花一小时写周报,还是 AI 已经从底表里自动生成了?你的考核指标是不是还是"工时 × 人数",而不是"调度的硅基时间 × 并行系数"?
如果答案都是"没有",那你的组织仍然是一家碳基公司。而碳基公司在硅基原生公司面前,不是被打败,而是被维度降维——就像马车在汽车面前,不是跑得慢,而是根本不在同一赛道。
下一章我会接着回答第二个问题:
为什么传统组织在 AI 面前会系统性失效?
从流程、考核、激励、决策四个层面,拆解那些过去被视为"企业基石"的东西,为什么在硅基时代反而成为最大的负担。
//手动注解:
"让 AI 写周报、开发代码即周报"的实践,是我在 CSDN 内部正在推行的一项具体改造,不是来自外部报告。它的本质是用一个小切口倒逼整个组织走向"过程即底表"——当 AI 写周报这件事被认真做好,commit 信息、PR、Jira 任务、PRD、OKR 就必须全部结构化地串起来,否则 AI 写不出有效的周报。这是我们理解"底表化"这个抽象概念的最小可行实验,也欢迎同行交流各自的落地方式。
本章引用的关键外部数据与观点来源:(Claude Opus 4.7 对此负责)
- Claude Code / Anthropic 数据 :Anthropic 官网、SaaStr、Sacra、Bloomberg(2026 年 4 月 14 日 8000 亿美元估值报道)、Yahoo Finance、The Next Web、Anthropic 官方工程博客《Building a C compiler with a team of parallel Claudes》
- Cursor/Anysphere 数据 :CNBC、TechCrunch、Contrary Research、公司公告
- a16z 观点 :Big Ideas 2026 系列(Jennifer Li、Malika Aubakirova、Stephanie Zhan 等合伙人)
- YC 观点 :Garry Tan 关于 revenue per employee 的公开表态;W26 Batch 数据(ellenox.com、extruct.ai)
- Claude Code Agent Teams 限制 :Claude Code 官方文档(code.claude.com/docs/en/agent-teams)、Shipyard、MindStudio、Medium 多篇实战复盘
- OpenClaw / NemoClaw :Nvidia Newsroom GTC 2026 发布、TechCrunch、Fierce Network、Ken Huang Substack
- Agent Memory 基础设施 :The New Stack、Mem0 官方博客《State of AI Agent Memory 2026》、arXiv:2601.11653(ACC 记忆压缩论文)
- Observability 生态 :Futurum Research 2026 年 1 月调研、Cisco 收购 Galileo 的公告、Braintrust/LangSmith/Arize 各家产品文档
- 意图驱动 :KodeNerds Intent-Driven Development 2026、InfoQ Agentic Engineering Patterns
- Sam Altman :关于"一人十亿美元公司"的群聊引述(来自 2024–2025 年多次公开采访)
📘第四章:秩序的代价-当时间单位变了,旧组织为什么会失效
接着前三章,谈谈“当时间单位变了,旧组织为什么会失效?”
真正能证明一个时代变了的,往往不是观点,而是那些最不该慢的公司,开始慢了。昨天最稳的管理制度,可能正是今天最大的增长税。
微软有全世界第一的开发工具 Visual Studio/VS Code、全世界第一开源开发者平台GitHub、超过7000名工程师在开发工具部门 ;JetBrain 有二十多年积累下来的 世界第二IDE 工具和上千万持续用户,超过2000名员工;GitHub 则站在 1.8 亿开发者网络之上。按旧世界逻辑,入口、用户、生态、工程师、资本,牌几乎都在这些巨头手里。可真正让市场突然意识到“下一代已经来了”的,却先是 Cursor 这种几十人团队的产品,以及 Claude Code 这种由十余名核心工程师驱动、却能高速迭代的 agentic coding system。
这不是大公司突然变笨了。
也不是小团队突然成神了。
而是竞争单位变了,时间结构也变了。
旧组织真正开始失效的,不是努力,不是资源,而是它背后那整套默认前提:时间是线性的,任务要顺序推进,信息靠层层传递,试错代价很高,所以组织必须优先追求秩序、控制、复制和稳定。
问题是,AI 正在把这套前提一层层打穿。
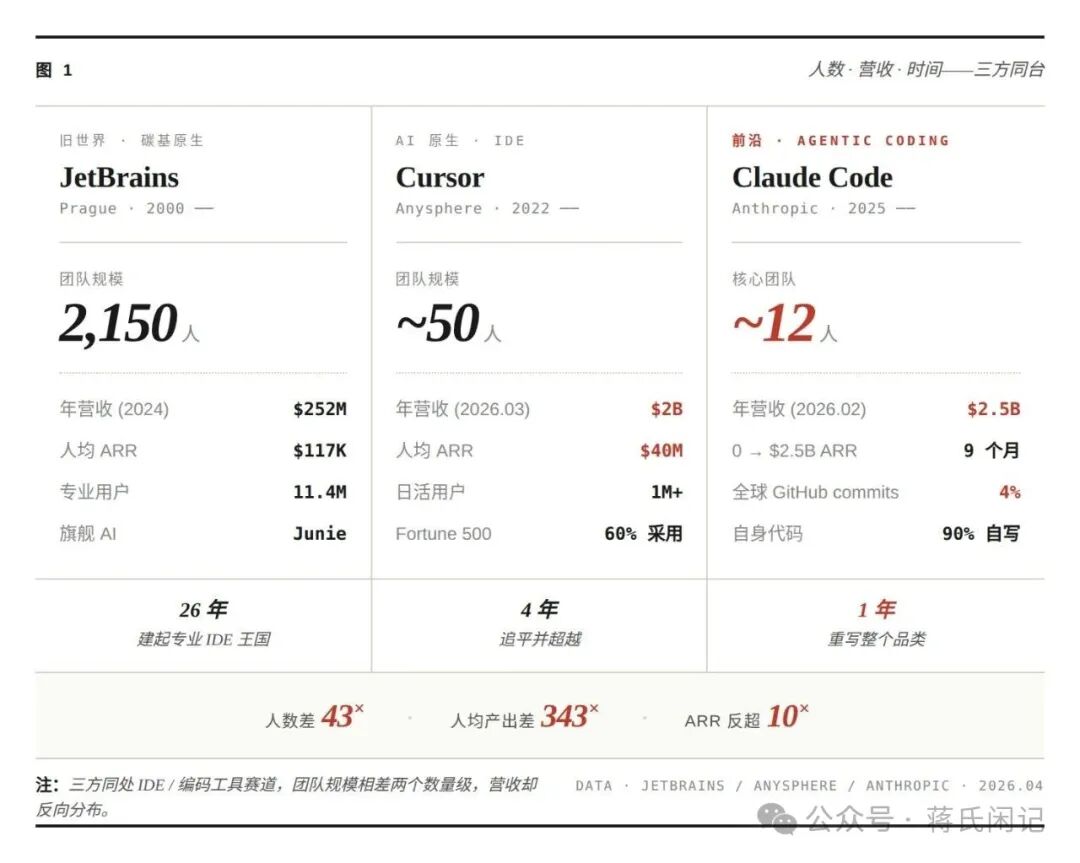
从上图可以清楚看到,JetBrains 代表的是旧世界成熟 IDE 体系的高地:两千多名员工、上千万持续使用用户、二十多年建立起来的专业工具王国;微软则通过 Visual Studio、VS Code、GitHub、Copilot 和 Azure,几乎掌握着开发者工具世界最厚的入口与生态;可与此同时,Cursor 以极小团队冲到极高收入规模,Claude Code 的核心构建与发布团队只有十余名工程师,却能实现极高的内部发布频率和惊人的产品推进速度。真正刺眼的,不是“小团队做成了大事”,而是“旧世界最厚的牌,正在失去对未来产品形态的天然定义权”。
最不该慢的人,先慢了
如果大公司只是偶尔输掉一次产品竞争,这不值得写进一篇文章,更不值得写进一本书。市场里总有周期,总有误判,总有一两次押错方向的时候。可如果连最有资源、最多工程师、最多用户、最深生态、最强入口的组织,都开始在 AI 原生产品上显得迟缓、犹豫、笨重,那就说明,出问题的不是某一条产品线,不是某一个高管,也不是某一次战略失误,而是支撑它们长期成功的那整套方法,开始和新的生产力发生冲突了。
过去,开发者工具竞争的是入口。谁占住 IDE,谁占住代码托管平台,谁拥有插件生态,谁就更接近开发者。今天,竞争正在切换成另一件事:谁能真正理解任务,连续调用工具,跨文件修改代码,运行测试,修复错误,直到把结果交付出来。竞争单位,已经从“工具”转向“任务闭环”;从“人使用软件”转向“人给目标,Agent 跑链路”。
这不是功能升级。
这是范式切换。
所以真正的问题不是,为什么 Cursor 跑得快,为什么 Claude Code 让人震撼。真正的问题是:为什么资源最厚的传统巨头,反而越来越难率先做出真正的 AI 原生创新?
答案不在产品。
答案就在组织。
一、流程为什么从保障秩序变成压制速度
流程曾经是现代管理最伟大的发明之一。它把经验变成步骤,把高手能力沉淀成系统能力,把复杂协作变成可复制动作。只要组织开始扩张,只要任务开始复杂,只要协作跨部门、跨角色、跨层级,流程就会自然出现,因为在碳基时间时代,企业最怕的不是慢一点,而是乱掉、错掉、返工掉。
所以旧流程的底层逻辑非常清楚:
先把路想清楚,再让所有人按同一条路走。
这在过去完全正确。
因为过去最贵的是犯错。
今天最贵的是错过。
这两句话之间,就是一个时代的分界线。
在旧世界里,试错成本高,反馈速度慢,返工代价大,所以流程越清晰,组织越稳定;节点越明确,责任越容易压实;路径越统一,质量越容易保证。丰田、麦当劳、IBM、微软这些旧时代强者,几乎都是流程能力的胜利者。它们不是靠几个天才扛起业务,而是靠把经验沉淀成 SOP,把能力沉淀成系统,把组织运行变成一套可复制、可扩张、可控制的秩序机器。
但 AI 改写了这个前提。今天很多知识工作,已经不再只有一条最优路径。一个产品方案可以同时生成多个版本,一个运营动作可以同时跑多个创意方向,一个研发任务也可以让代码、测试、文档和监控同步展开。过去我们说“先把事情想清楚再做”,是因为同时试几条路太贵;现在越来越多的场景里,“先同时跑几条路,再用反馈收敛”,反而更便宜、更快,也更接近真实世界的解法。
问题就在这里。
旧流程最擅长把单线做稳。
它最不擅长让多线并发。
节点越多,等待越多。
前置确认越多,探索越少。
局部越稳,整体越慢。
于是今天越来越多公司的困境,不是流程不规范,而是流程太规范;不是没有秩序,而是秩序本身开始压制速度。每一个节点看起来都合理,每一步审批看起来都专业,每一层确认看起来都在降低风险,但合在一起,整个组织却在失去另一样更重要的东西:对变化的响应速度,对新机会的捕捉能力,以及在不确定里快速试验、快速修正、快速收敛的能力。
流程没有错。
错的是,流程还在服务旧速度。
未来真正先进的流程,不会消失,但会换一种结构。它不再是一条线性的审批铁路,而更像一张支持多路并行、实时反馈和动态收敛的调度网络。它不再追求一开始就锁死路径,而是允许组织先把更多可能性展开,再让数据和反馈来决定方向。这种新流程还没有现成模板,它本身就是 AI 时代最大的基础设施机会之一。
过去最好的流程,是减少失误。
未来最好的流程,是缩短收敛。
二、层级为什么从管理手段变成信息损耗器
层级制曾经也是现代组织最理性的选择之一。公司一旦变大,老板就不可能直接看见所有问题,高层也不可能同时理解一线全部细节,信息、决策和责任都必须经过中间层来完成传递、压缩与承接。层级在旧时代首先不是权力结构,而是信息结构;它存在的原因,不是人喜欢管人,而是没有层级,很多信息根本上不来,很多决策根本下不去,很多责任也根本落不到具体位置上。
所以层级在过去解决的是规模问题。
组织越大,层级越有必要。
协作越复杂,层级越显得合理。
在那个时代,中层最重要的价值,不在于“官”,而在于“桥”。他知道上面在想什么,也知道下面在发生什么;他把混乱的信息压缩成可汇报的内容,把抽象的战略翻译成可执行的动作,把碎片化的问题整合成领导能够处理的版本。没有这样的中间层,很多大组织根本转不起来。
但今天,AI 和底表系统正在迅速削弱这种“桥”的价值。客户反馈可以实时进入系统,任务状态可以持续更新,研发过程可以自动留痕,会议纪要可以自动生成,异常波动可以即时预警。信息第一次不必再主要依赖“人转述”,而越来越可以直接被“系统呈现”。
一旦这个前提松动,层级的另一面就会被看得更清楚:
它不只是传递信息。
它也在损耗信息。
一线看到的是问题本身。
基层主管汇报的是他理解后的问题。
中层再往上报的是适合向上表达的问题。
高层最后拿到的,往往已经不是原始问题,而是经过筛选、修饰、压缩和组织化处理后的版本。
过去,这种损耗是可以接受的,因为没有更好的办法。
今天,这种损耗越来越不值得了。
真正危险的,并不是层级存在,而是层级仍然主要依靠信息不透明来证明自己的价值。如果一个中层最重要的作用,还是“只有通过我,你们才能互相看见”,那他的价值基础其实已经开始摇晃了。未来真正有价值的管理者,不应该是信息转运站,而应该是判断放大器;不应该靠垄断信息存在,而应该靠提升组织认知质量存在;不应该只是上传下达,而应该定义目标、处理冲突、做出高阶取舍、在复杂不确定中进行校准。
层级不会消失。
但层级会被重写。
过去层级是桥。
今天很多层级正在变成墙。
而当层级这堵墙开始漏水时,你会发现一个更本质的问题:组织的时间结构,整个地,错了。
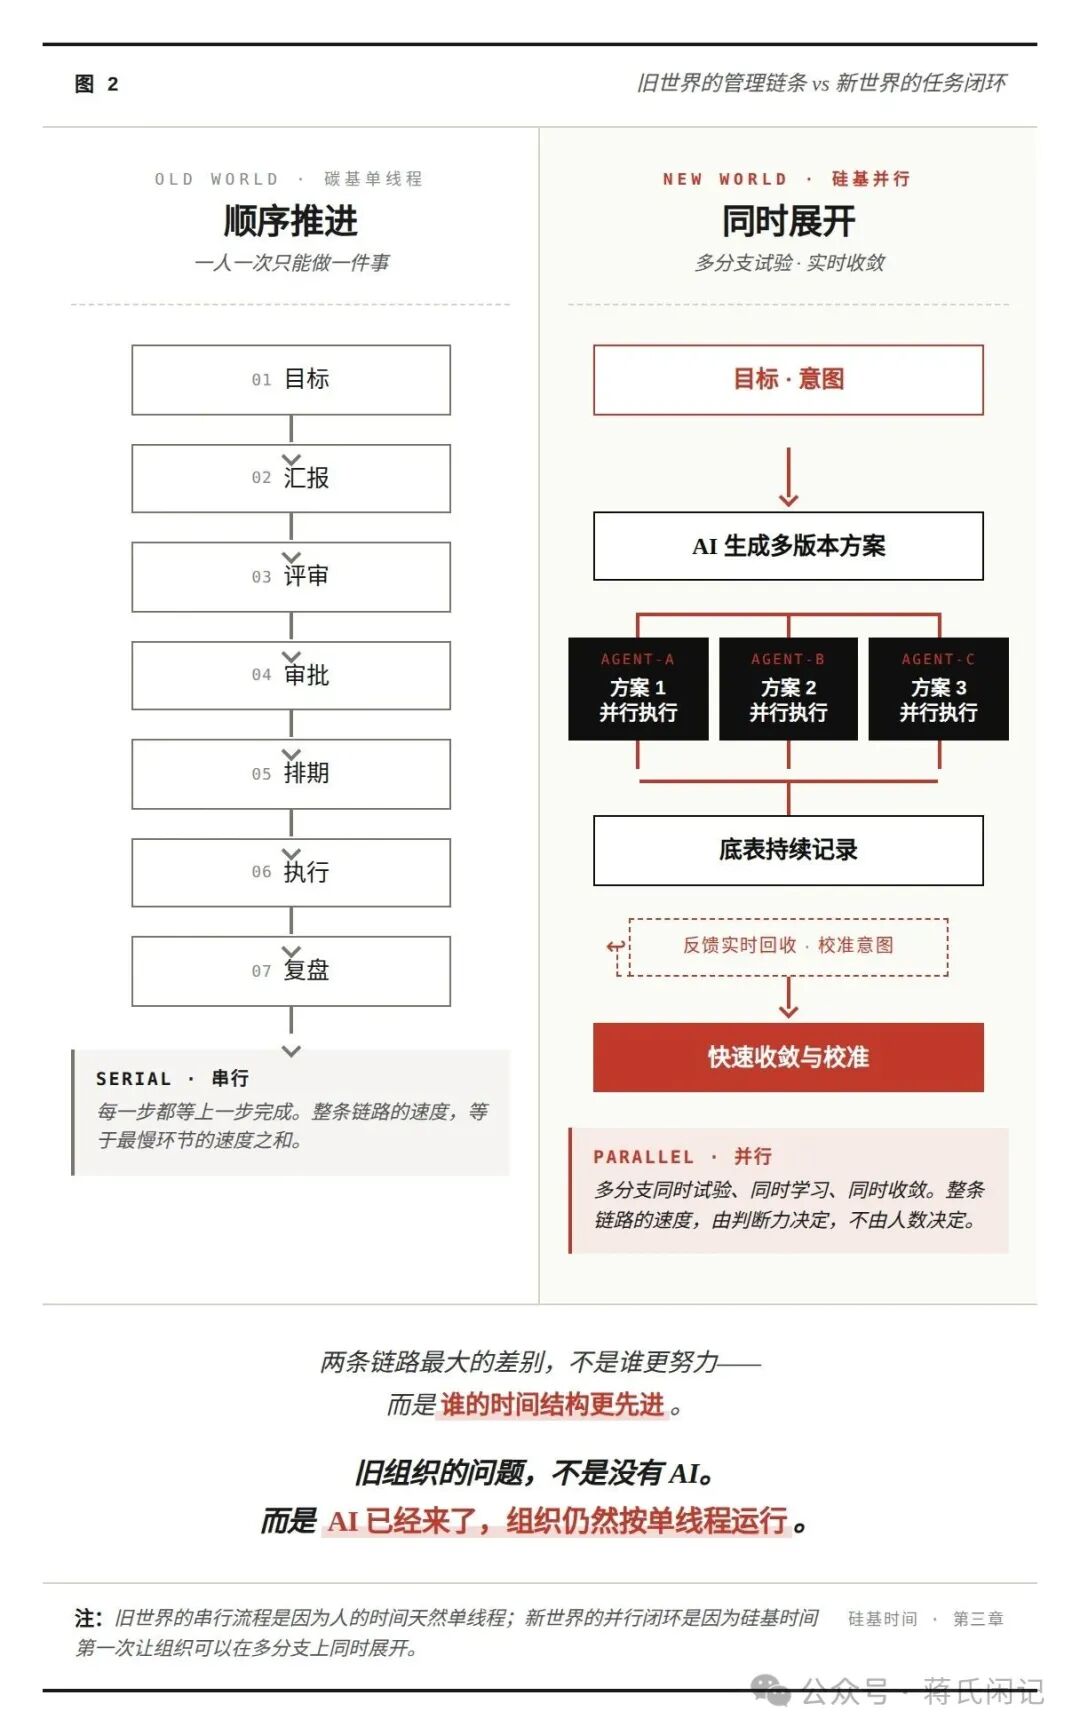
这两条链路最大的差别,不是谁更努力,而是谁的时间结构更先进。旧世界依赖顺序推进,因为人的时间天然单线程;新世界依赖并行展开,因为硅基时间第一次让组织可以在多个分支上同时试验、同时学习、同时收敛。问题不是旧流程有没有价值,而是它是不是还在强迫整个组织按单线程节奏运行。
旧组织的问题,不是没有 AI。
而是 AI 已经来了,组织仍然按单线程运行。
三、KPI 和OKR不是落伍,而是必须被重写
一谈到组织失效,很多人最容易否定就是 KPI 和 OKR。好像只要进入 AI 时代,目标管理就天然落伍,结果考核就天然僵化。这样的判断听起来很新,实际上并不深,因为任何一家真正要经营、要增长、要交付的组织,都不可能不要结果,也不可能不衡量结果。
所以,KPI 和 OKR 没有失效。失效的是旧用法。
过去,KPI 之所以有效,是因为它把复杂组织中的结果先简化成一组可以对齐、可以追踪、可以问责的数字。OKR 之所以有效,是因为它让组织知道自己到底在往哪里走,避免大家各忙各的,看起来都努力,结果彼此抵消。在旧时代,这套方法非常合理,因为结果在很大程度上就是岗位动作的累计:销售多跑一点,运营多做一点,研发多交付一点,组织的总结果就会上去。
但 AI 改写了结果的形成方式。今天越来越多的价值,不再是某个岗位单独努力的结果,而是“人 + AI + 底表 + Agent + 工作流”共同作用的结果。一个销售业绩的提升,可能来自更好的客户分层、更快的跟进节奏、更高质量的话术迭代和更及时的异议识别;一个产品增长的改善,可能来自更高频的实验、更短的反馈周期、更多版本的并行测试和更快的修正机制;一个研发效率的提高,也未必只是程序员写得更快,而更可能来自需求澄清、代码生成、自动测试、文档同步和上线监控之间形成了更紧密的闭环。
这时候,如果组织还只在终点看结果,就会出现一个很大的问题:
结果还在优化。
但优化的,已经不是决定未来结果的那组变量。
所以,KPI 和 OKR 必须升级,不是从“有指标”变成“没指标”,而是从“终点打分”升级成“过程调度”。今天的指标体系不能只停留在结果层,还必须往前拆,进入真正驱动结果的 output 因子;再往下沉,进入可观测、可追踪、可复盘的底表字段。
真正有力量的管理链路,不该只是“目标—执行—复盘”这么粗。
它应该变成:
目标结果 → 用户价值 → output 因子 → 底表字段 → AI/Agent 持续优化
没有底表的 KPI,最后容易变成表演。
没有因子拆解的 OKR,最后容易变成口号。
这也是为什么很多旧组织明明“指标很全”,却越来越难做出 AI 原生产品。问题不是它们不重视指标,而是它们还在优化旧指标:装机量、渗透率、续费率、附着率、功能覆盖率,这些都很重要,但未必再是最关键的。真正决定用户会不会转向新一代 agent 工具的,已经越来越是另一组变量:任务完成率、连续执行能力、跨文件修改成功率、错误自修复率、从目标描述到最终交付的闭环长度。
指标没失效。
失效的是,用旧指标去优化新竞争。
四、周报、会议、审批为什么正在失去意义
周报、会议、审批,几乎构成了过去组织运行的日常肌理。一个组织看起来是否“成熟”,往往就体现在这些动作是不是完整:有没有汇报机制,有没有例会体系,有没有审批链路,有没有层层确认。过去,这套系统并不荒谬,相反,它很合理,因为当过程不可见、状态不透明、责任难锚定时,组织只能靠这些形式来让自己“看见自己”。
所以周报的本质,是延迟同步。
会议的本质,是集中同步。
审批的本质,是责任同步。
在旧时代,这些同步方式有存在价值。
但 AI 和底表化正在改变这一切。
如果任务状态已经实时记录,过程节点已经自动留痕,关键异常已经系统提醒,会议纪要可以自动生成,摘要和趋势也能即时呈现,那么很多周报就不再是在创造信息,而是在重复信息;很多会议不再是在形成判断,而是在同步已经同步过的内容;很多审批也不再是在提升质量,而更多是在转移责任、延缓决策、制造心理安全感。
这就是今天越来越多组织的真实困境:人人看起来都很忙。 但真正的创造越来越少。 大家在写周报。 大家在开会。 大家在等审批。 可真正推进事情的时间,早已被这些动作磨成了碎片。
最可怕的是,这种低效往往还披着“认真管理”的外衣。因为它看起来有秩序,有记录,有参与,有责任链条,有流程感。可如果这些动作没有带来更高质量的判断,没有带来更快的反馈,没有带来更短的决策链,那它们本质上就不再是组织的骨架,而是在吞噬组织的注意力。
未来组织不是不要协同。
而是不要低价值协同。
凡是信息同步型会议,都会越来越被系统吞掉。
凡是状态复述型周报,都会越来越被 AI 代写。
凡是低价值、可规则化的审批,都会越来越被自动流转替代。
未来真正稀缺的,不再是“大家都知道了”。
而是“谁能更快做出高质量判断”。
五、为什么碳基管理,天生容不下硅基并行
如果说前面讨论的还是流程、层级、指标和协同这些制度层面的变化,那么走到这里,问题其实已经更深了。真正开始失效的,不只是几项制度,而是支撑这些制度的那套管理哲学本身。
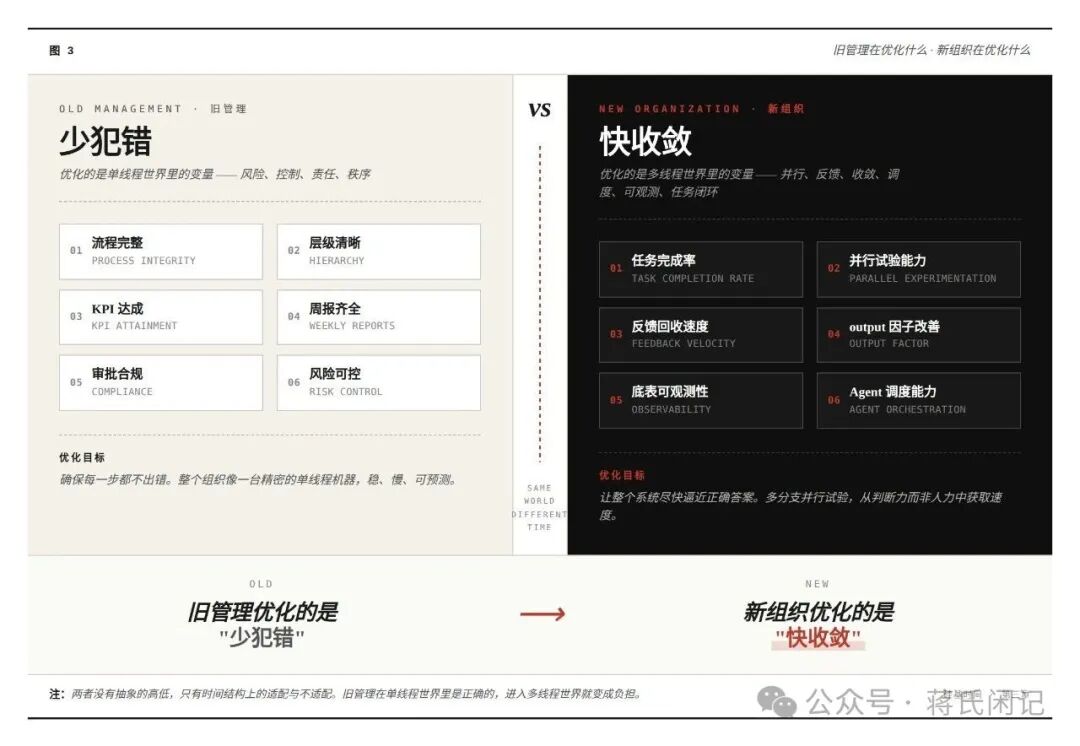
碳基管理的根本假设,是人是唯一生产主体。所以组织围绕岗位设计,围绕职责划分,围绕汇报线运转,围绕人的纪律、服从、努力和经验来构建秩序。它天然偏好线性、顺序、稳定、边界清晰,因为人的时间本来就是单线程的:一个人不能同时跑十个版本,不能同时收回一百路反馈,不能无成本复制自己,也不能在长链条执行里长时间保持稳定一致。
所以,旧管理的核心目标一直是控制。
控制风险。
控制偏差。
控制责任。
控制节奏。
控制成本。
控制不确定性。
这在人的世界里没有问题。
问题在于,AI 带来的不是“更听话的工具”,而是“可扩展的执行能力”。
硅基时间最重要的意义,不是把原来的动作加快一点,而是把原来做不到的并行,变成可能。任务可以复制,路径可以并发,反馈可以实时回收,多个 Agent 可以同时推进不同分支,再由人来做校准与收敛。这意味着,组织第一次可以不再只依赖“先定好一条路,再让所有人排队走”,而是可以让多条路同时展开,让系统去快速试错,让反馈去淘汰错误路径。
而这,恰恰是旧管理最不习惯的地方。
碳基管理天然讨厌冗余,因为冗余意味着浪费;
硅基并行却恰恰需要一定程度的冗余,因为没有并发试验,就没有快速收敛。
碳基管理喜欢职责固定,因为固定更容易考核;
硅基调度更强调动态编排,因为任务会随着反馈不断重组。
碳基管理喜欢先想清楚,再开始动;
硅基系统则更适合先展开,再通过高频反馈逼近正确答案。
所以,很多组织即使已经采购了模型、部署了 AI、让员工开始使用新工具,仍然本能地在用旧制度压制新能力:要求所有试验先写清楚再审批,要求所有结果必须归回旧岗位,要求所有新工作流最终仍然服务于旧报表、旧汇报、旧考核。于是 AI 被拿来写纪要、润色 PPT、代写周报、加速一些边缘动作,却没有真正进入主生产系统,没有真正改变组织的时间结构。
这就是为什么旧组织最难的,不是接入 AI。
而是承认:
原来的管理方式,已经开始阻止 AI 发挥作用。
未来最强的组织,不会只是让每个人都多学几个 AI 工具,也不会只是把原来的人力流程简单叠加一层自动化。它们更本质的变化,是把组织的基本单位从“岗位”转向“任务”,把管理的核心从“控制人”转向“调度能力”,把经营的逻辑从“顺序推进”转向“并行展开、反馈收敛”。
从岗位管理,走向任务编排。
从职责分工,走向能力调度。
从结果打分,走向 output 因子与底表驱动。
从顺序执行,走向硅基并行。
这不是效率优化。
这是管理重写。
结语:组织不是被 AI 替代,而是被自身的慢淘汰
一家组织真正的衰老,往往不是从人才流失开始,也不是从某个产品失败开始,而是从它对时间的理解落后开始。
流程越来越重,不是因为流程有罪,而是它还在服务顺序时代。
层级越来越钝,不是因为管理者不努力,而是信息已不必再靠层层转述。
KPI 和 OKR 越来越失真,不是因为结果不重要,而是结果形成机制已经改变。
周报、会议、审批越来越令人疲惫,不是因为协同不需要,而是低效同步正在吞噬创造。
碳基管理越来越难驯服 AI,不是因为它保守,而是因为它天生适配的是单线程世界。
所以,旧组织不是因为老而失效。
它是因为默认的时间假设,已经过期了。
回到开头那个问题:为什么不是微软或 JetBrains 先做出 Cursor? 答案现在已经清楚了——不是他们不想,是他们的组织,还活在单线程时代。
昨天最稳的管理制度,可能正是今天最大的增长税。
组织不是被 AI 替代,而是被自身的慢所淘汰。
//后续章节将回答三个更有建设性的问题: 第一,新组织到底长什么样。 第二,AI 原生公司有没有一套可复用的方法论。 第三,AI 原生时代,什么样的人会成为新的关键角色,尤其是 AI 原生工程师、AI 原生管理者、AI 原生 CEO。
请感兴趣的朋友们点关注,AI时代原创文章更容易,但有思想的原创不多见。
硅基时间 · 目录
#硅基时间
上一篇硅基时间第三章:企业和个人的新生产函数下一篇硅基时间第五章:新组织如何重建
修改于2026年4月19日
📘第五章:新组织如何重建
从岗位管理到任务编排,从人力驱动到硅基调度
旧组织正在失效。 但真正危险的,不是旧制度失效本身,而是很多公司还在用旧制度的想象力,去理解新世界的组织。
第四章已经说明,旧制度之所以僵化,是因为它们都建立在同一个前提之上:时间是稀缺的、线性的、低并发的。工业时代,一个人一次只能做一件事,于是岗位、层级、汇报和审批成为维持秩序的必要结构。但 AI 时代改写了这个前提——当硅基时间开始大规模进入组织,任务可以被拆解,流程可以被重构,能力可以被调用,协作可以被并行,旧组织赖以成立的底层逻辑就开始松动。
我在和很多 CEO 交流时,最常听到一种焦虑:"我们也在用 AI,人均效率好像也提升了,但为什么感觉公司整体还是没变?"
这个问题背后,藏着一个被大多数人忽略的真相——把 AI 塞进旧组织,和把组织改造成 AI 原生组织,是两件完全不同的事。前者最多是给旧机器换几个新零件,后者是重新设计整台机器。
真正的问题不是"要不要用 AI",而是:既然旧组织不再适配,新组织到底应该怎么搭?
答案并不复杂,却足够颠覆。
旧组织围绕人来排班。 新组织围绕任务来编排。
这不是一句管理口号,而是 AI 时代组织重建的总开关。这一章,我会从五个层面完整拆解:组织的基本单元、管理对象、协同方式、基础设施、管理者角色。
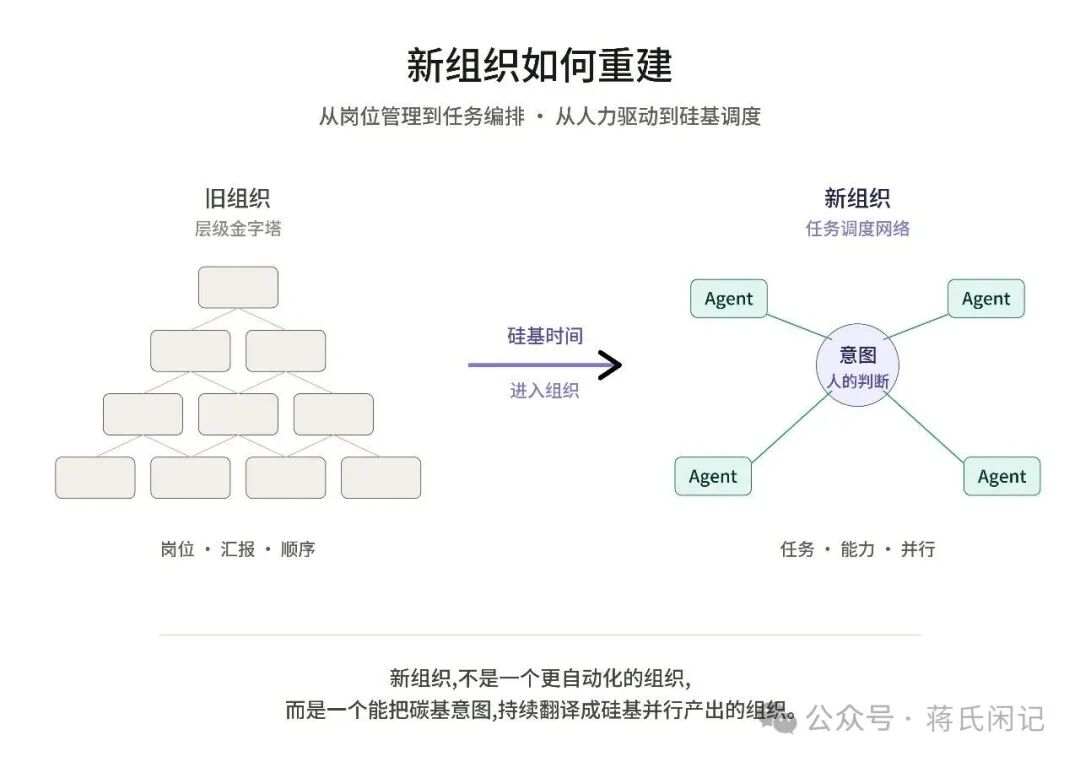
一、组织的基本单元,不再是岗位,而是任务
工业时代最伟大的组织发明之一,就是岗位。它把复杂工作切成稳定、重复、边界清晰的职责单元——只要流程稳定,这种方式就能支撑规模化协作。
但岗位逻辑有一个默认前提:一项工作必须由某个固定角色,沿着某条固定路径来完成。这个前提今天正在被打穿。
两年前我在一家大型SaaS 公司做顾问,CEO 苦恼地说:"我们产品加了 3 个人,研发加了 5 个人,AI Cursor也都配上了,但新功能交付反而更慢了。" 我让他带我看工作台,问题一目了然:一个新功能从"用户提出需求"到"功能上线",要经过 11 个岗位的接力。产品助理写 PRD、产品经理 review、设计出稿、总监把关、前端排期、后端排期、测试介入、运维准备、PM 跟踪、CTO 审批、CEO 点头。
更讽刺的是——这 11 个岗位里有多个岗位的工作今天已经可以被 AI 完整承担。因为组织是按岗位切分的,AI 只是工具,而不是被嵌入任务流本身。结果是:每个岗位都"用上了 AI",但任务的整体流转速度没有任何变化。
这就是旧组织最深的病灶:岗位是静态的,任务是动态的。AI 擅长的是加速任务流,但你先把任务切成 11 段,再让 AI 去加速其中几段,中间的等待、交接、审批一分钟也没少。
真正的新组织做法相反。它不先问"缺什么岗位",而是先问: "这项任务由哪些能力构成?哪些可以自动化?哪些可以并行?哪些必须由人来校准?" 然后按任务来配置资源。岗位不再是起点,而是任务拆完之后的副产品。
岗位是工业时代的组织语法, 任务是 AI 时代的生产语法。
二、管理的对象,不再只是人,而是能力
任务取代岗位之后,管理对象必然迁移。
旧组织为什么天然以"人"为中心?因为那个时代能力几乎完全附着在人身上。一个优秀销售的判断,一个老工程师的经验,都锁在个人脑子里。组织要获得这些能力,只能通过雇佣、培训、提拔和留住这个人。
这种模式有一个极大的脆弱点:能力和人同进同出。人在,能力在;人走,能力也走。这就是为什么每家公司都怕核心员工离职——不是怕少一个人,是怕那个人带走的"组织记忆"再也找不回来。
但这个问题并不新。它是现代企业管理三十年来最重要的一条暗线——只是今天被 AI 重新引爆了而已。
华为的那句名言:消灭"王牌飞行员"
九十年代中后期,任正非从一份关于美军管理方式的研究材料里,读到一个让他反复咀嚼的洞察:
越战时期,美军发现战斗中大多数敌机,都是被极少数"王牌飞行员"击落的。这看起来是好事。但五角大楼的研究员给出一个冷酷判断:一支过度依赖王牌的军队,不是强大,而是脆弱。因为王牌一旦阵亡或退役,整支部队战斗力会断崖式下跌。真正的强军,是能不能让普通士兵也打出王牌级别的水准。
美军后来把王牌飞行员的战术动作、决策模式、临场判断,逐条拆解、结构化、嵌入训练大纲。结果是整个空军作战能力的系统性提升——王牌不是被取代,而是被稀释;能力不是被垄断,而是被流通。
任正非把这句话带回了华为: "要消灭'王牌飞行员',让平凡的人做出不平凡的业绩。"
华为把销售高手的客户判断、一线工程师的技术积累、项目经理的节奏把控,拆解成可教、可查、可复制的流程、模板、案例库和作战手册。一个新人进入华为,不需要摸索五年才能成为高手,因为高手走过的路,已经被写进了系统。华为可以从 2 万人扩张到 20 万人,核心就在于它不依赖王牌,它批量生产王牌。
今天的新版本:skill 蒸馏
三十年过去,同一个命题,正在被 AI 以更极致的方式重新演绎。
最近一个月,一个半玩笑式的说法在科技圈流传开来——"人走了,skill 被蒸馏了"。一个资深员工的工作方式、判断逻辑、决策偏好,现在可以通过分析他过去的沟通记录、项目材料、决策轨迹,被 AI 提炼成一套可复用的"skill",封装成 Agent,挂在任何新人身边做副驾驶。
华为用了二十年沉淀能力,今天的 AI 可能只需要几个月。华为把能力写进作战手册,今天的 AI 把能力编译成可执行的 Agent。底层逻辑完全一致,但速度和粒度被推到了一个新量级。
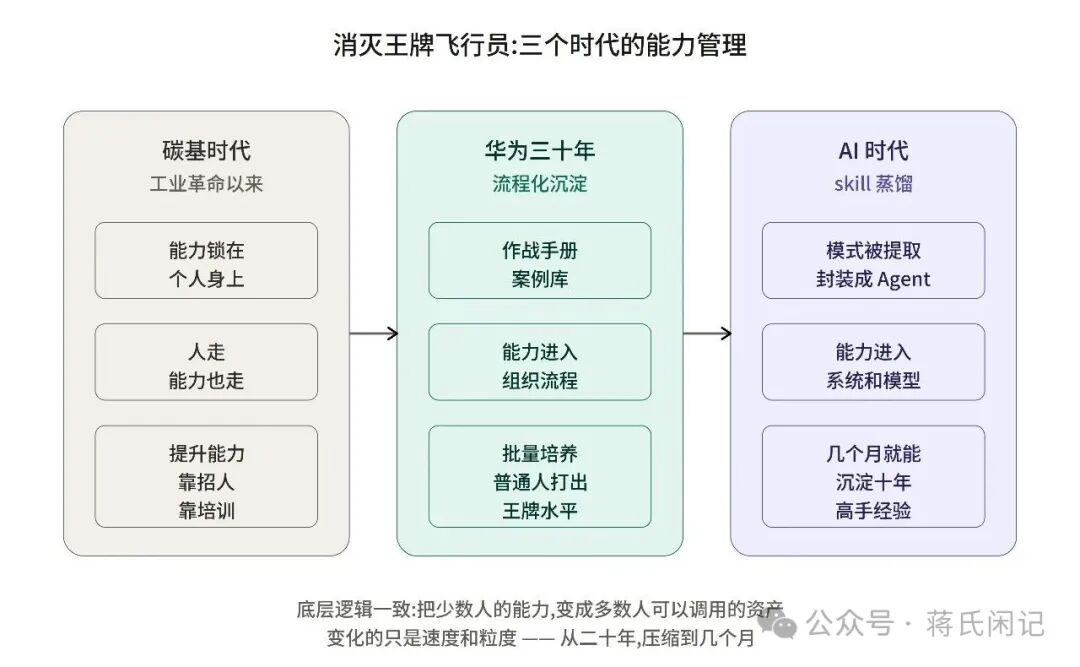
未来组织真正要管理的,不再只是"多少人、谁汇报给谁",而是:我们有哪些关键能力?哪些仍然绑定在个别人身上?哪些已经进入系统?哪些可以被复用、被调度?
管理者看待团队的方式也会彻底改变。过去他看到的是岗位配置,未来他看到的应该是能力网络。不是"我们还缺一个运营总监",而是"我们到底缺的是用户洞察能力、内容生产能力,还是转化分析能力"。
未来企业真正稀缺的,不是人头,而是可被稳定调用的能力供给。
讲到这里,一个刺耳的质疑会立刻浮出水面:
"如果我的经验都被 AI 蒸馏成 skill 了,那我是不是就没价值了?"
我的回答分两层:
第一层:被蒸馏的是动作,不是人本身。
能够被 AI 封装成 skill 的,永远是那些可被重复、可被结构化、可被抽象成模式的部分——一个销售的话术套路、一个工程师的调试步骤、一个运营的 SOP 经验。这些东西重要,但它们恰恰是一个人身上最不独特的那一层。
真正让一个人不可替代的,是那些只有在真实情境里才会浮现的判断:当客户说"你们价格有点高"时,这一次到底是真的预算问题,还是讨价还价的信号——AI 可以学会 99% 的常见模式,但永远学不会这一次的此时此刻。当一个产品方向明显走不通时,是坚持还是转身,不在于数据怎么说,而在于你愿不愿意为自己的信念承担代价。AI 不会承担代价,人才会。
换句话说——被蒸馏的是你做过的事,不是你这个人。
第二层:真正危险的,不是被蒸馏,而是"只有可被蒸馏的部分" 。
如果一个人的全部工作都能被 skill 蒸馏掉,他在 AI 时代确实会贬值。因为他做的事情本来就是"机械重复的高级劳动"。这就是只会把PRD和JIRA任务翻译成代码的程序员,他的工作职能正在消失。Anthropic CEO说50%的初级白领工作会消失的原因。
对每一个职场人来说,AI 时代真正的命题不是"抗拒蒸馏",而是:
你的价值里,有多少比例是可以被蒸馏的,有多少比例是不能的?不能被蒸馏的那部分,你有没有在持续变厚?
华为"消灭王牌飞行员",不是为了让王牌失业,而是让王牌不再被日常重复拖住,可以去打更高级的仗。一个销售高手如果每天都在做重复跟进,天花板就是一个销售;但如果他的经验被沉淀成系统,让团队里 20 个新人都能打出 80 分水准,他才从"一个王牌"变成"一个将军"。
作战手册替换的是"新人要摸索的部分",不是"高手要突破的部分"。 skill 蒸馏替换的是"昨天的你",不是"明天的你"。
旧组织最怕人走,因为能力跟着人走。 新组织不怕人走,因为能力已经在系统里沉淀; 但同时,它比任何时候都更需要那些能持续产出"不可蒸馏价值"的人。
三、协同的方式,不再是顺序推进,而是并行展开
旧组织最习惯的协作方式,是接力赛。一个任务来了,先给产品,再给设计,再给研发,再给测试,再给运营。谁做完,下一棒才开始。
这种方式建立在碳基时间的天然约束之上:人无法分身,信息交换成本高,所以最稳妥的办法是把流程切成一段一段。
但当 AI 进入组织之后,最大的浪费已经不再是"某个人做得不够快",而是大量任务还在排队。
某互联网公司做过一次复盘,发现一个典型功能从立项到上线的 40 天周期里,真正"动手做"的时间只有 11 天,剩下 29 天都在等——等审批、等资料、等前一棒交付、等会议拍板。73% 的周期被等待吞掉了。
很多企业所谓的低效率,本质上不是懒,而是等。AI 最深的价值,不只是提速,而是让更多任务不必再排队。
从"一次一版"到"一次几十版"
一个真实的变化——线上产品运营的文案和前端设计。
旧做法是串行的:运营提活动主题,文案写 1 个标题、2 个备选;设计在文案确定后出 1 版主视觉;前端按设计稿做 1 个落地页;测试通过上线,跑一周看数据。两周过去,整个流程里真正接触到"用户真实反应"的只有最后那 1 个版本,前面所有判断都是团队在内部自己猜的。
新做法完全不同。运营提出主题后,几十条生成线同时启动——文案 Agent 生成 30 个标题方向;设计 Agent 生成 20 版主视觉;前端 Agent 把文案和视觉自动组合成 60 个落地页候选。几小时内,桌面上不是 2-3 个方案,而是几十个完整可上线的方案组合。
但这只是一半。几十个方案如果没有配套的自动化基础设施,只会变成新的混乱。
真正的变化是整套协同系统同时升级:方案生成自动化——几十个候选几小时内同时生成;投放调度自动化——每个方案先跑 1% 流量,差的自动下线,好的自动扩流量;反馈回路自动化——点击、停留、转化数据几分钟内回传,系统自动做显著性检验;学习沉淀自动化——跑出的最优组合抽取成模式,进入下一轮素材库——下次活动,起点比这次更高。
一次活动的迭代周期从两周压缩到 48 小时;真正被用户验证过的方案,从"团队猜出来的那 1 个",变成"数据筛出来的那 3 个"。
真正的变化不是速度,是"真相来源"
很多人看到这个场景,第一反应是"效率提高了"。这个判断太浅。
真正的变化是:团队做判断的依据,从"内部最资深的人觉得哪个好",变成了"几十个方案同时接受真实用户检验后,数据告诉我们哪个好" 。
旧做法里,会议桌上最有经验的那个人,通常赢。新做法里,让方案上线比让方案通过评审更便宜。真正的裁判从"会议室里最资深的人",变成了"真实用户的点击和转化"。
旧协同是:先在内部收敛,再对外展开。 新协同是:先对外展开几十版,再靠数据收敛。
这里有一个反直觉但极其重要的观察:并行展开需要"冗余" 。传统管理最讨厌冗余,但在 AI 时代,硅基时间的成本已经降到碳基时间的 1% 左右——你还在用老办法,就等于亲手放弃了 AI 时代最大的红利。冗余在新成本结构下,不再是代价,而是获取真相的必要成本。
还有一个常常被忽略的观察:这套"同时跑几十个方案、自动投放、实时反馈、快速收敛"的工作方式,过去只有字节跳动这种顶级互联网公司才真正具备——它需要庞大的增长团队、自研的投放中台、成熟的 A/B 实验平台。几百人、几年时间、上亿投入堆出来的组织能力。绝大多数中小公司只能望洋兴叹。
但今天,这个门槛正在被 AI 迅速抹平。过去需要字节级别组织能力才能跑通的工作方式,今天一个 20 人的团队也能跑起来。
这就是 AI 时代最被低估的一层变化——AI 不仅在平权个人能力,更在平权组织能力。过去被少数巨头垄断的"系统化作战方式",正在变成中小公司触手可及的基础能力。
这也解释了为什么很多传统组织接入 AI 后没有真正释放并行价值:他们只是用 AI 把原来那一个方案做得更快,而不是用 AI 同时做几十个方案来接受检验。这不是效率问题,是工作方式问题。
旧协同像流水线,新协同像编队飞行。 流水线讲究节拍一致、前后衔接;编队飞行讲究各自独立、统一指挥、可随时重组。
未来企业之间的效率差距,往往不取决于谁更努力,而取决于谁更早识别出:哪些任务本来就不该继续排队;以及,哪些决策本来就不该在会议室里靠猜完成。
四、新组织的基础设施,不是报表,而是活底表
当任务成为基本单元,能力成为管理对象,协同开始并行,组织接下来最需要补上的,不是更多会议,而是一套新的基础设施:活底表。
所谓活底表,不是多几张表、多上一套 BI。它真正指的是:企业那些原本散落在会议、聊天、文档、经验和个体记忆中的经营过程,被持续记录、结构化沉淀,并能够被 AI 理解、调用和推动。
它至少包含五层:
任务底表——一项任务从哪里来、拆成哪些子任务、推进到哪一步、卡在哪; 过程底表——一次会议讨论了什么、一个项目怎么迭代、一次沟通怎么流转; 反馈底表——一个客户为什么成交、为什么流失;一次上线为什么报错; 能力底表——谁擅长什么、哪些经验已经沉淀成模板、哪些动作可以被 Agent 复用; 决策底表——一个决策为什么这样做、当时依据了什么数据、放弃了哪些方案。
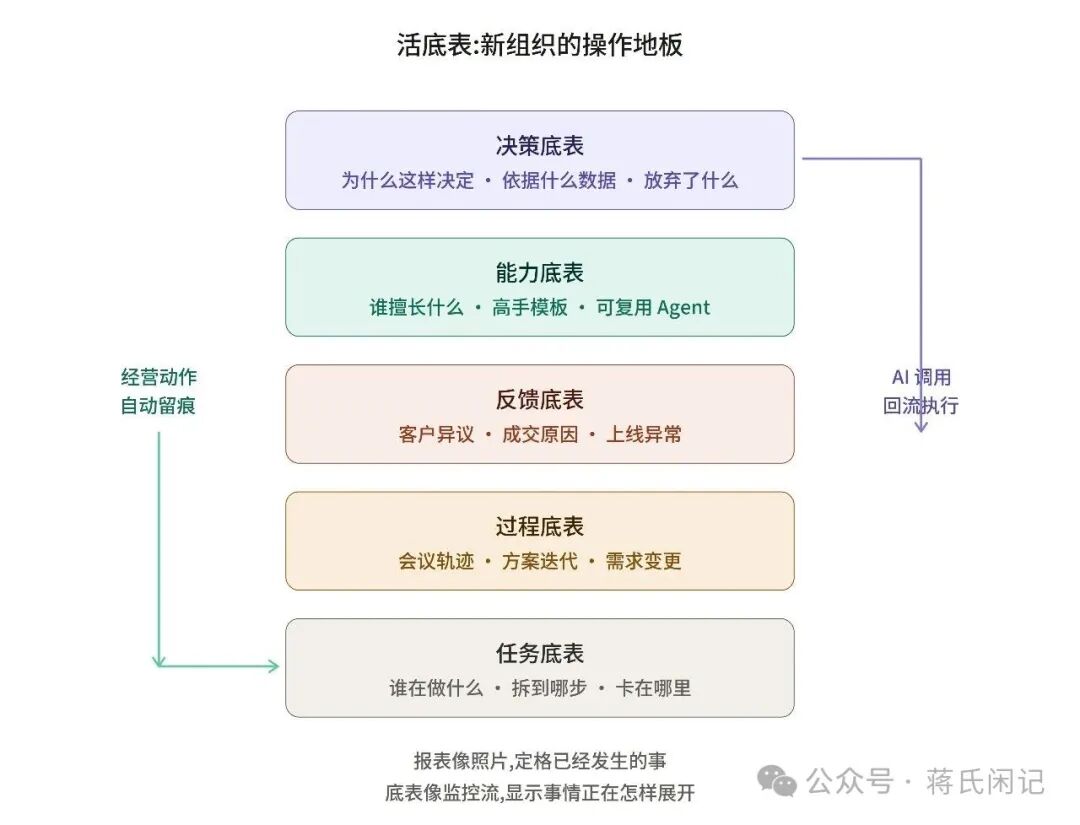
为什么必须是"活"的?因为它不是月底才整理,不是老板问起才补。它应该随着经营活动实时生成、实时反馈、实时回流到执行。
下面用真实场景,把活底表落到具体。
案例:一次客户流失,两家公司的 72 小时
两家做得差不多的 B2B SaaS 公司,ARR 都在 5000 万左右,都有一个年费 80 万的腰部客户"华明制造"。合同到期前 45 天,华明的 IT 负责人在一次例行对接会上说了一句:"我们最近在评估另一家产品,老板问了几次 ROI。"
A 公司是报表公司。客户成功经理把这句话记在笔记本上,想着周五写周报时提一下。等开会讨论已是第 10 天——这时华明已经和竞品签了意向书。
B 公司是底表公司。这场会议本身就在底表上,AI 实时转录后 30 秒内,系统做完四件事:任务底表生成"华明续约风险"工单并开始计时;反馈底表把"ROI 质疑"打上"续约早期预警"标签;过程底表把这次对话挂到华明 6 个月的健康度时间线上;能力底表识别出"ROI 质疑+合同到期 45 天内+高管层提问"这个组合在过去 7 次流失里出现过 5 次,自动把成功续约经理的 3 个打法模板推到对应的人面前。
72 小时内,客户成功经理带着 AI 自动生成的 ROI 复盘材料见了华明老板,带回关键反馈:"客户不满的不是产品,是看不到产出"。这条反馈进入底表的瞬间,又触发了三件事——关联到另外 14 个客户的类似抱怨,生成"客户价值看板"需求,并把"不谈产品,先谈价值"的打法抽取成新模板。
华明最终续约,金额还加了 15 万。但这不是最关键的部分。
30 天后,B 公司又遇到类似信号,系统的反应不是 30 秒,是 3 秒——因为华明的完整轨迹已经训练过系统一次。A 公司遇到第二个类似信号时,一切要从头再来——因为上一次的经验留在了离职员工的脑子里、散落的周报里、没有纪要的会议里——留在任何系统都调不到的地方。
案例二:一次线上故障,两家公司的 4 小时
如果华明的案例证明活底表让经营动作停止蒸发,那么这个研发案例要证明的是——哪怕是最"数字化"的部门,没有活底表依然只是在碎片化地运行。
两家 80 人研发规模的公司,都用 GitHub、Jira、Datadog、PagerDuty——工具完全一样。周四 21:47,核心支付接口同时告警,成功率从 99.9% 跌到 94%。
C 公司的值班工程师打开 Datadog,第一件事是拉群。20 多人进群,一个经典问题:"今晚谁发版了?"没人回答。有人翻 Git,有人查 CI/CD,有人翻飞书——每个人打开不同的系统,看到不同片段的真相。40 分钟后 CTO 入群,第一句话还是:"现在到底什么情况?"没人能用一句话回答。
D 公司的值班工程师打开的是"故障中枢" ,90 秒内看到 AI 已经做完三件事:自动创建故障单并拉齐责任人(任务底表);聚合过去 2 小时所有变更,圈出 19:32 的退款逻辑版本为重点嫌疑(过程底表);错误日志实时聚类,92% 指向数据库连接池超时(反馈底表)。
更关键的是能力底表触发了:原作者已转岗,但系统通过代码评审历史、提交频次自动识别出"最熟悉这段逻辑的人"是小周。小周打开看到的不是群消息,而是结构化简报——嫌疑 diff、3 处最可疑改动、过去类似故障的处理记录、2 个回滚方案及影响面。
C 公司从告警到恢复,用了 1 小时 48 分钟——大部分时间在拉群、找人、拼时间线。 D 公司从告警到恢复,用了 34 分钟——小周确认回滚的同时,AI 已自动扫描依赖、生成复盘材料、并识别出另外 2 个服务有相似代码模式,直接生成预防性工单。
3 个月后,C 公司另一个服务出现几乎一模一样的"未关闭连接"问题,整个流程从头走了一遍——因为上次的复盘纪要和过去 50 份一样,静静躺在共享盘里。6 个月后,D 公司类似故障发生率下降 60% 。不是工程师变强了,是每一次故障都在训练系统。
报表公司与底表公司
报表公司关注汇总——月底复盘、季度经营会、出事之后找材料解释。 底表公司关注生长——任务进行中就有轨迹,偏差出现时就有预警,AI 可以随时接进去推动执行。
旧组织把经营理解为"做事之后写下来"。 新组织把经营理解为"做事的同时留下可被调用的轨迹"。
活底表真正的价值,不是老板看得更细,而是公司学得更快。过去做十个项目,在人脑子里留下十段模糊经验;未来做十个项目,在系统里留下十条完整轨迹、十组偏差模式、十套可提炼模板。做过的事情会反过来训练公司。
这才是 AI 时代最可怕的竞争力。不是某一次做得更快,而是越做越会做。
一家公司有没有活底表,最简单的检验方式就是问一句:同一个问题发生两次,第二次比第一次快多少? 如果答案是"差不多",那不管装了多少 AI 工具,它本质上还是报表公司。如果答案是"数量级地快",那它已经开始长出真正的组织智能。
五、管理者的角色,不再是监督者,而是调度者与校准者
当任务可以被追踪,过程可以被记录,能力可以被调用,系统比人更适合做一件事:监督。
哪些任务延误了,哪些客户有流失风险,哪些需求反复返工——系统往往比任何主管更早看到。所以管理者如果还把主要价值放在催办、检查、盯进度上,本质是在和机器竞争机器最擅长的事情。这注定会迅速贬值。
一天 8 小时里,大多数中层管理者大约 5 小时在"同步信息"——开例会、看周报、追进度、处理跨部门协调。剩下 3 小时才是真正的判断和决策。一个管理者如果不升级,他 80% 的工作都将被系统蚕食;如果升级成功,他的杠杆反而会被放大 10 倍。
未来管理者真正的价值,集中到两个新角色上:调度者和校准者。
调度者:一个真实案例
调度者关心"什么最值得先完成" ——判断关键任务是什么、哪些可以并行、哪些资源该由人承担、哪些交给 Agent、哪些节点需要人工拍板。
一个真实的例子来自我们 CSDN 自己。
我们有一个叫 AtomCode 的项目,对标 Claude Code 的命令行版本。核心开发者是公司的高级 VP,同时是一位资深架构师。他用 28 天,带着一个后期扩展到 3 人的小团队——前期大部分时间只有他一个人——完成了核心功能的复刻。
这个数字有多反常,对比一下就知道了。
两年前,CSDN 做过另一个编程工具产品 InsCode,和 AtomCode 的复杂度接近。当时用了不到 10 人的团队,做了 6 个月。两年前也已经是大模型时代,InsCode 本身就借助了 AI 辅助开发——但那时的模型能力、Agent 编排方式、开发范式,都还在早期。同一家公司、类似的产品方向、相近的工程量——从 6 个月压到 28 天,从 10 人压到 1-3 人。
这个对比真正揭示的是:硅基时间不是一次性红利,而是以年为单位持续加速的生产力变量。两年前用 AI 的做法,今天已是旧方式;今天用 AI 的做法,两年后大概率也会被认为是旧方式。谁先升级工作方式,谁就享受下一轮的压缩红利。
这位顶尖架构师做对的是三件事。
第一,先定义架构。他没有一上来就让 AI 写代码,而是花了大量时间把技术架构想清楚——核心模块是什么、接口长什么样、数据流怎么走。架构一旦定对,后面的所有任务都可以并行展开;架构如果错了,几十个 Agent 并行生成的代码,反而会变成更大的技术债。这是调度者和普通开发者最大的区别——前者愿意花几天时间不写一行代码,只把地图画清楚。
第二,把任务拆解成 Agent 可执行的粒度。每个模块被拆成足够小、足够明确的任务单元,带着清晰的输入、输出、上下文约束。拆解的本质,是把模糊的意图翻译成硅基时间可以并行消化的结构化指令。
第三,为每个任务定义衡量标准。什么样的代码算通过?什么样的接口算合格?他把这些标准显性化、自动化,让 AI 可以在没有人干预的情况下反复迭代、自我进化——生成一版、评估一版、不行重来,达标提交。人不再是执行环节,而是规则的制定者和最终的仲裁者。
他不是"写得最快的那个人",而是"把问题定义得最清楚的那个人" 。一个人在 28 天里完成的工作量,如果用两年前的方式需要 10 个人干 6 个月——差距不是 10 倍,是接近 60 倍的生产效率跃迁。
校准者
校准者关心"方向对不对、质量够不够、边界清不清楚" 。因为 AI 可以放大执行,也会放大偏差。一个错误目标会被执行得更快,一个模糊提示会被扩散成更多低质量结果。未来管理者最重要的工作,不是替团队做事,而是在关键节点上校准目标、质量和边界。
新管理者的日常动作会发生根本变化:
少盯动作,多盯目标。 少守岗位,多拆任务。 少催进度,多调资源。 少抓日常,多抓异常。 少做替代,多做校准。
监督是信息不透明时代的管理补丁。 调度,是任务可计算时代的核心能力。
未来最稀缺的管理者,不是写代码最快的工程师,不是管人最多的 VP,而是能把一个复杂问题拆解到"AI 可以自动迭代收敛"那个粒度的人。
六、真正的组织重建,不是把 AI 加进旧公司,而是把公司改写成一个调度系统
很多公司也在用 AI——写文案、查资料、做会议纪要、做 PPT。这些都有价值,但大多停留在"旧组织 + 新工具"的阶段——用 AI 让旧流程跑得更快一点,但流程本身、组织本身、协同本身都没有变。
这就像 1900 年的工厂主把蒸汽机换成了电动机,但依然把电动机放在工厂中央,用皮带驱动所有机器——直到几十年后,有人意识到:电动机真正的价值不是替代蒸汽机,而是让每一台机器都可以有自己独立的动力,从此工厂的布局、流水线的设计、整个生产组织的方式全都可以重写。
AI 今天在大多数公司的位置,就像那个被放在工厂中央的电动机。它被用了,但没有被释放。
真正的组织重建,远不止于"用上 AI"。真正的变化是:
不再围绕岗位去固化职责,而开始围绕任务去编排能力; 不再围绕人头去理解管理,而开始围绕能力网络去理解组织; 不再依赖顺序推进,而开始让任务并行展开; 不再依赖汇报总结,而开始依赖活底表去感知经营; 不再把管理者定义为监督者,而开始把他们定义为调度者与校准者。
这时,公司本身就不再只是一个由人组成的层级结构,而越来越像一个任务调度系统,一个能力调用系统,一个不断训练自己的组织中枢。
最重要的一句话,不是"AI 提高了效率",而是:
新组织,不是一个更自动化的组织, 而是一个能把碳基意图,持续翻译成硅基并行产出的组织。
旧组织的核心资产是编制, 新组织的核心资产是可调用的任务能力。
过去公司越大越强, 未来公司越会调度越强。
真正的 AI 原生组织, 不是人人都在用 AI, 而是公司本身已经开始像一个智能系统那样运转。
//笔者注:
下一章我想和你聊聊,管理者如何从"开会的人",变成定义目标、校准系统、训练组织的人。这个进化,我自己也在学习和实践中,很多判断还在摸索,希望能收到更多朋友的反馈,让这个命题在更多真实经验里长得更扎实。
请感兴趣的朋友们点关注,AI时代原创文章更容易,但有思想的原创不多见。
硅基时间 · 目录
#硅基时间
上一篇硅基时间第四章:秩序的代价-当时间单位变了,旧组织为什么会失效下一篇OPD:硅基时间的每个公司里都需要一个 Steve Jobs(但他不需要会写代码)
修改于2026年4月20日
📘第六章:硅基时间在 CSDN:从 YC 的_AI 原生公司_到我们自己的实验
《硅基时间》系列文章发表后,得到不少朋友好评,也收到很多同样的提问:**"道理我都懂——可怎么落地?你自己做得怎么样?"**
这篇文章是我的回答。
我正亲自在 CSDN 推行一场 AI 驱动的产研实践。这一个月,我们做了三场闭门会、跑了一个 5 人零基础实习生实验、上线了一条研发底表闭环、把 Token 配额提升到了"令人不舒服的高"。这里把过程、数据和踩过的坑一并分享给大家——既是阶段性汇报,也想让"硅基时间"这套方法论从纸面走到地面。
2026 年 4 月最后一周,YC 主投 AI 方向的核心合伙人 Diana Hu——这位累计完成 1700+ 小时创业者 Office Hours、以技术眼光著称的 YC 灵魂人物——在 Startup School 上抛出了一个判断:AI 不该是公司用的工具,AI 应该是公司运行的操作系统。
同一周,我在 CSDN 内部连续开了三场闭门会,得出了几乎一样的结论。
这不是巧合——这是同一场范式转移在硅谷和北京的两面。
一、YC 和 CSDN 在同一周说了同一句话
Diana Hu 这次演讲在硅谷创业圈炸了。作为 YC 5 个 batch、累计完成 1700+ 小时创业者 Office Hours、过去几年硅谷数百家 AI Native 创业公司的"近距离观察者",她的判断很有分量。她的核心论断很狠:如果你保持原有的组织结构图和管理结构,你就完全错过了这场转变。AI 不是 Copilot——你不能把它"加"到现有公司上,你必须把整个公司重新围绕它来构建。
我看完她的演讲那天晚上,把 4 月 7 日、4 月 20 日、4 月 24 日这三场 CSDN 内部会议的录音转录用AI提炼核心点后发现一个事实——YC 这几个月观察到的硅谷数十家 AI 原生公司的共同特征,和我们这个月内部反复试错的方向,几乎逐字一致。
她讲"closed loop";我们讲"底表化"。
她讲"queryable organization";我们讲"过程即数据"。
她讲"1000x engineer";我们刚见证 3 个不会 Rust 的工程师半个月重写 Claude Code。
她讲"DRRI 替代中层管理";我们刚抛出"岗位制必须破"。
她讲"token maxing 取代 headcount maxing";我们刚把每人月 Token 配额从 50 美元拉到 1000 元。
跨地域、跨语境、却惊人一致。这不是追潮流,这是被同一个公式牵着走:
产出 = 碳基时间 +(硅基时间 × 并行系数)
老公式默认人 = 时间;新公式里,时间可以买、可以并行、可以脱离人独立运转。这个公式带来的所有组织含义,YC 看见了一面,CSDN 看见了另一面。两面拼起来,才是完整的范式。
未来最强的公司,不一定是人最多的公司,而是最会调度硅基时间的公司。
二、AI 是操作系统,不是工具
Diana 这句话翻译成最朴素的话是:别再问"AI 能帮我提效多少"——这个问题本身就错了。
提效 20% 是工具思维。AI 原生公司不是"提效",是根本不再以人为执行单元。每个流程、每个决策都流经一个不断学习和改进的智能层——人在边缘给意图、做仲裁,不再站在中间传递信息。
CSDN 内部一份 AI 自动生成的研发周报上,有这样一组数字:
- 一周 174 个 Jira 工单 / 254 次 commit
- 新增 6 万多行代码
- 其中 AI 代码生成率 86.2%
-
一周 Token 消耗约 2 万元
86.2%——把这个数字咀嚼一遍。当代码已经不是程序员"写"出来、是"调"出来的时候,写代码的能力贬值,调 AI 写代码的能力升值。
但更关键的不是 86.2% 这个数字,是这份周报由 AI 自动生成这件事。它读 Jira、读 commit、读 Cursor 使用记录,自己提炼汇总——人不再产出周报,人产出 commit 和 Jira;周报这个"管理接口"被 AI 接管了。
Diana 在演讲里讲了一个一模一样的场景:YC 投资的某些公司,把 Agent 接到 Linear 工单、Slack 工程频道、客户反馈、GitHub commit、Notion 计划文档、销售电话录音上。Agent 自己分析"上一个 sprint 实际交付了什么、有多大程度满足客户真实需求",然后给工程师提出更准确的下一周 sprint 计划。结果是:sprint 时间减半,产出接近 10 倍。
YC 的硅谷小队和 CSDN 的北京产研,在做几乎完全相同的事——**让 AI 直接读公司的底表,跳过人类汇报这个有损接口**。
三、底表化:让公司变成可查询的“硬地基”
为什么底表化这么重要?因为不底表化,研发效能评估就有三大黑盒:
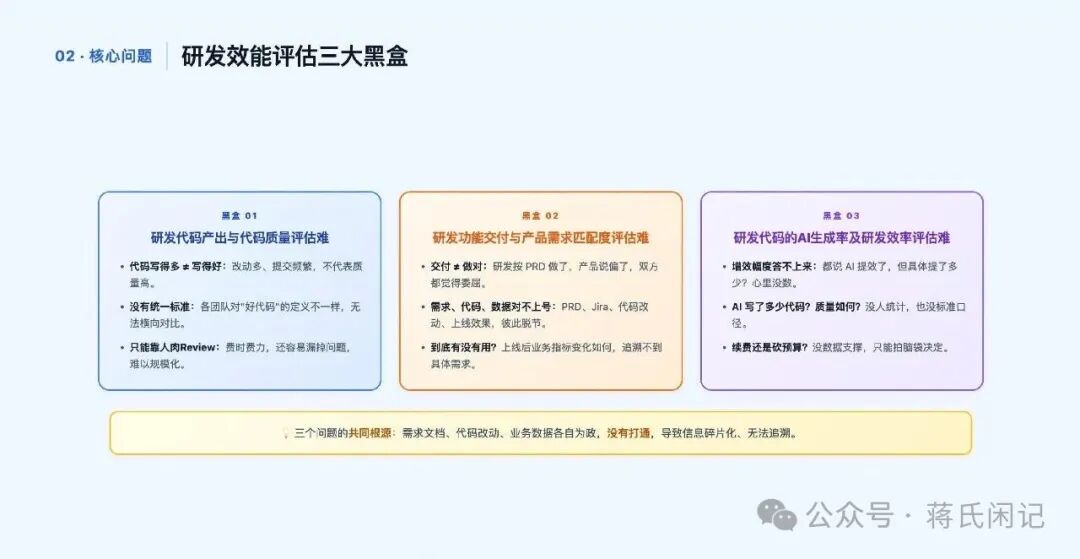
这三个黑盒共同的根源是——需求文档、代码改动、业务数据各自为政,没有打通,导致信息碎片化、无法追溯。
Diana 借用了控制论里的一个区分:open loop(开环)vs closed loop(闭环) 。
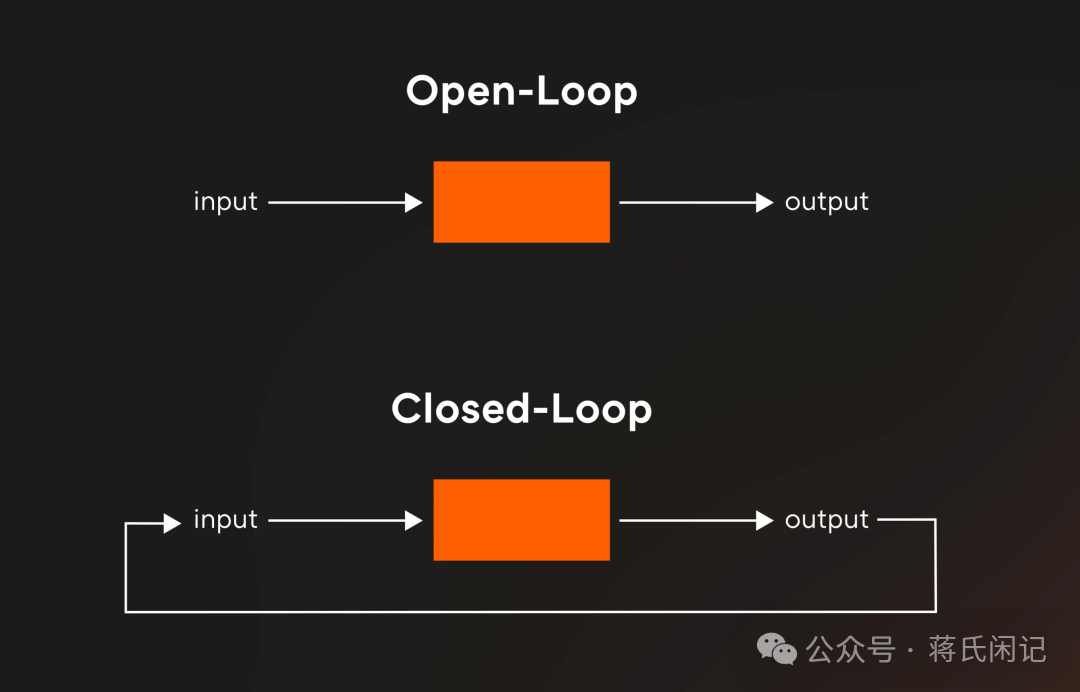
开环:做决策、执行、但不系统性测量结果。信息流失、错误累积、改进依赖人工干预。
闭环:每个动作产出一个 artifact,智能层自动学习并调整流程。
她讲得很狠:"传统公司基本都是开环系统,每天无数会议、无数决策被解决——但 90% 的知识随风而逝。下次遇到类似问题,团队又要从头思考。"
要从开环变闭环,必须做一件硬事:让整个公司变得 queryable(可查询) ——每一个重要动作都必须产生一个 AI 能读的 artifact。这就是我们内部说的"底表化"。
把约束写进 Git Hook,不是写进规范
我们在 GitLab 里设置了一个 hook——任何 commit 如果不关联 Jira、commit message 与代码改动不一致,根本无法合并到主分支。
这不是规范,是物理屏障。
设计哲学很简单:底表化不能靠自觉。靠口号靠例会,三天后所有人都会回到老路;写进工具,不规范在物理上就不可能发生。
我们打通的整条研发底表闭环是这样的:
业务指标 → PRD → Jira → commit(强制关联)→ AI 自动评估 → 数据回流到上线 Jira
具体到工程实现,三阶段链路全景图是这样:
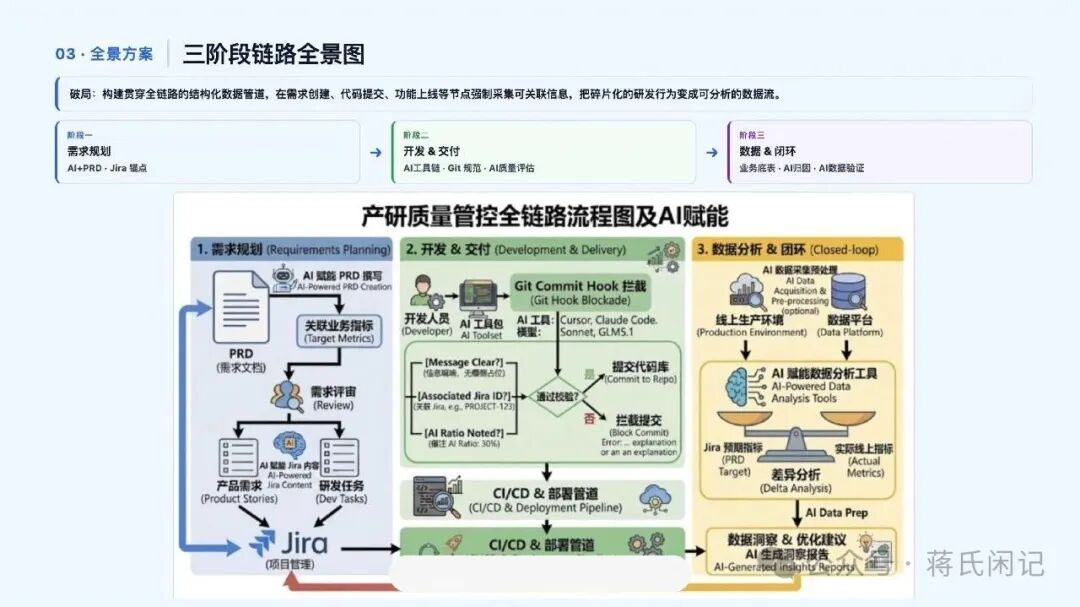
产研质量管控全链路流程图及 AI 赋能
破局点在于——构建贯穿全链路的结构化数据管道,在需求创建、代码提交、功能上线等节点强制采集可关联信息,把碎片化的研发行为变成可分析的数据流。
具体到 Git 提交环节,我们设计了三项强制校验:
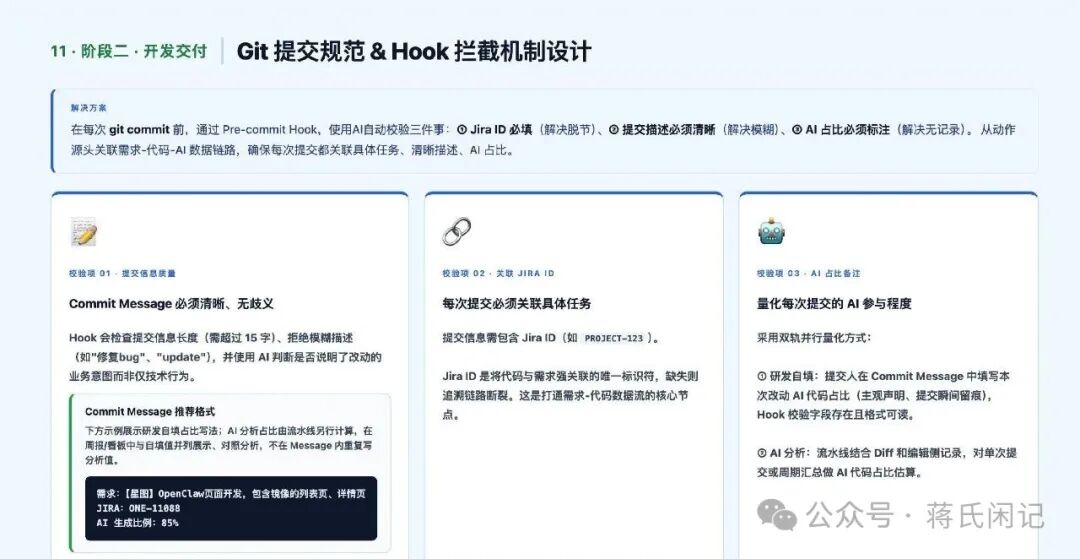
Git 提交规范 & Hook 拦截机制
在这条闭环里,AI 给每一次提交打三个维度的分:
- 代码实现质量 :可读性、结构、边界处理等硬指标
- commit 说明与代码一致性 :避免"修复 bug"、"小调整"这种灌水空话
-
代码与 Jira 需求匹配度 :语义匹配 commit 是否真对应了它声称要解决的需求
第二个维度尤其关键——它解决了一个长期无解的痛点:commit message 灌水。碳基时代你不可能逐条 review 几百条 commit;但 AI 可以。当敷衍的 commit 会被自动识别、自动扣分,组织里的"糊弄成本"就被显性化了。
底表化的本质,不是为了管理更细,而是让真实过程重新可见。
反直觉的数据:AI 写得越多,bug 反而越少
数据底表跑通之后,最让我们意外的是产能数据。这是某周的真实研发效能看板:
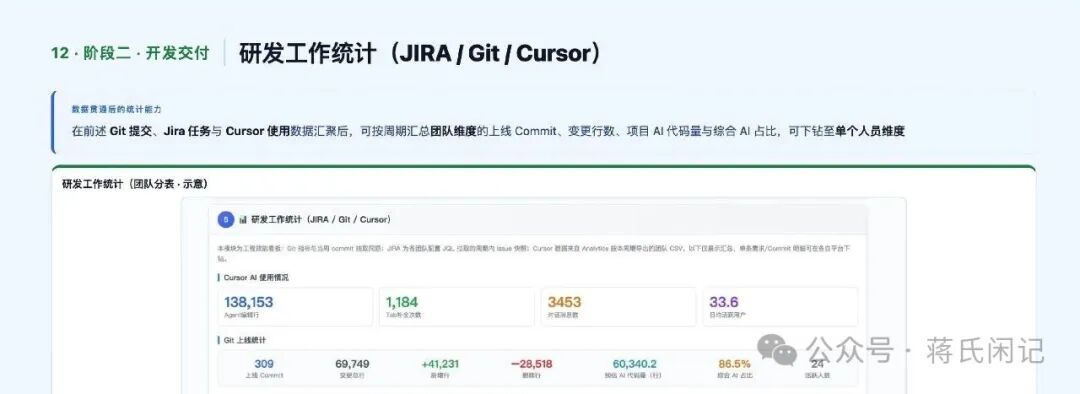
研发工作真实数据看板
24 个活跃研发、一周 309 个 commit、变更 6.9 万行、AI 代码生成 6 万行——**综合 AI 占比 86.5%**。
更反直觉的是质量数据:
测试 bug 数:1 月 186 个 → 4 月 62 个同期 AI 工具使用率持续上升,团队规模反而在缩小
直觉上你会以为:AI 写得多、bug 应该多——AI 会犯错、会幻觉、会抄串。但实际数据反过来。
为什么?三层原因:
- AI 不会偷懒 ——人会跳过单元测试、忘写边界检查;AI 不会
- AI 不会被打断 ——人写代码会被钉钉、会议、同事打断;AI 一气呵成
-
底表反过来训练了人 ——当 commit 必须经得起 AI 评分、Jira 必须真匹配代码, 敷衍这条路被堵死了
186→62 的本质,不是 AI 写得比人好,是底表化倒逼了整支团队的工作姿态升级。
AI 带来的不只是单点效率,是组织行为的整体校准。 过去管理靠人盯人,现在管理靠过程数据和智能反馈。
Software Factory:当 AI 能写代码,人的价值就从"会写"变成"知道什么是对"
Diana 在演讲里还提到一个更激进的方向——AI Software Factory。
逻辑是:人类只写规格和测试,AI Agent 生成实现、迭代、跑测试,直到通过。她举的例子是 strongDM AI 团队,他们的代码仓库里已经不再包含任何手写代码,只有规格和测试工具。
CSDN 的 AtomCode(全 Rust代码) 团队也验证了这一点。三位核心架构师都不会 Rust语言——但他们能写清楚架构规格、能定义"什么样的输出算合格"。剩下的一切由 AI 完成。语言不再是壁垒,架构判断力才是。
一句话总结:**当 AI 能写代码,工程师的工作就从"写代码"变成"定义什么样的代码算对" **。前者是手艺,后者是判断——这就是 Diana 反复讲的"千倍工程师"的真正含义。
YC 社群对这件事有一个更精准的画像——**"程序员正在变成产品经理型架构师" (Spec-Driven Engineer)。 如果你不能清晰描述逻辑和验收标准,AI 也救不了你**——硅基时间能跑多远,完全取决于碳基意图的精准度。
落地的四大坑:理念再好,先扛过这一关
要想富,先修路,工具网络层面要做好。否则前面所有的"全链路闭环"、"86.5% AI 占比"都无从谈起。CSDN 的方案很朴素:统一接入——公司层面开通 Cursor Team 账号 + 内部代理 Claude Code 服务,网络稳定、模型按需切换、人级配额灵活、用量全程可监控。所有员工开箱即用,不用海外卡、不用跑报销。
**本质是把 AI 工具做成水电煤——所有人打开就用,而不是每个人自己挖井**。这是公司能给员工最实在的"AI 时代基础设施"。
我们走到哪了
最后亮一下 CSDN 内部当前进度——避免给大家一种"已经完美"的错觉:
分阶段落地路径 · 已完成 & 规划中
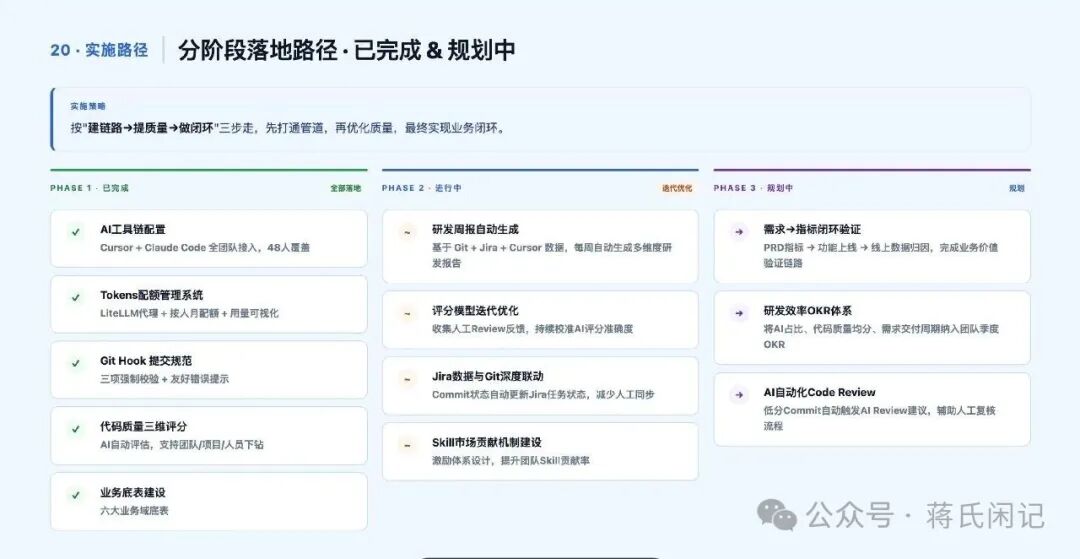
我们走的是"建链路 → 提质量 → 做闭环"三步——先打通管道、再优化质量、最终实现业务闭环。中间还有大量需要打磨的地方——但底表的硬地基已经在了。
四、AI 摸鱼选手:这个时代最隐蔽的岗位陷阱
闭环跑通之后,一个新的管理难题浮出水面——怎么区分"真在工作"的人和"在用 AI 摸鱼"的人?
我在内部反复讲过一个判断:
AI 是一个员工。你给他提的要求,决定了他的答案质量。
你只丢一句"帮我做个分析"——他就交一个能糊弄过去的版本;你说"帮我做个分析,要考虑这三个边界、要对照这两个历史案例、要给出三个不同方案的对比"——他给你的就完全是另一个东西。
同样的 AI、同样的 Token,不同的人提要求,产出差距是 10 倍以上。
这就是 **"AI 摸鱼选手"**——AI 时代最隐蔽、也最致命的新岗位陷阱。
它的画像:接到任务 → 丢给 AI → AI 一分钟搞完 → 提交 → 等下一个任务。表面看效率很高,实际上他把判断责任全部转嫁给了 AI。一个真正提要求的人跟 AI 对话不会一分钟搞完——他会反复说"这个边界没考虑到"、"那个异常路径漏了"——一来一回,可能要花半小时。
前者是把 AI 当外包,后者是把 AI 当团队。前者在逃避判断,后者在放大判断。 碳基时代考核看产出(代码量、上线次数);AI 时代必须看对话质量——因为代码已经不是你写的了,你的价值全部体现在"你对 AI 提了什么"里面。
Diana 在演讲里给出了同一件事的另一面——Token Maxing:"最好的公司将是 token maxing 的公司,而不是 headcount maxing 的公司"。给真正会调度 AI 的人配足 Token——5% 成本换 500% 效率(对照黄仁勋"50 万美元工程师配 25 万美元 Token"那句话);而摸鱼选手必须被识别——他们在浪费团队 Token、浪费利润、还在制造低质量产出污染信息池。
Token 不是成本,是新的生产资料。但前提是——它必须掌握在高判断力的人手里。
YC 社群里有句更狠的话直接戳破了这件事: "API 账单是你的新雇员成本。" 当 API 支出能替代 10 个人的薪资,账单看起来再吓人,人效比和利润率也是惊人的——**未来公司的估值逻辑,会从"劳动力密集型"转向"计算力调度型"**。
五、中层管理消失:DRRI、AI Founder、岗位制要破
Diana 这一段最锋利:经典的管理层级在 AI 原生公司里不再有意义。
"在旧世界,你需要中层管理者协调者来低效地传递信息。但在新世界,智能层承担了这个目的。如果你的公司是可查询的、artifact 丰富的、对 AI 可读的——你应该几乎没有人类中间件。"
YC 社群里给这件事起了个更精准的名字——** "去路由化"(De-routing):中层的本质工作是"信息路由器";当 AI 能实时总结 Slack、Linear、commit 时,信息差不复存在—— "扁平化组织"第一次具备了在大规模团队里真正落地的可能**。
她引了 Jack Dorsey 在 Block 的实践,提出未来公司只剩三种员工原型:
- IC ——建造者和操作者。AI 原生公司里"每个人都是 IC",开会时带可工作的原型而不是 PPT
- DRRI ——一个人对一个结果负责到底,没有矩阵汇报、没有躲藏的地方
-
AI Founder type ——创始人必须站在最前沿, 不能把 AI 战略外包给某个技术负责人 ,必须亲自用 Cursor、用 Claude Code,直到打破自己关于"什么是可能的"的先验假设
CSDN 内部走到的这一步,是抛出了一个更狠的判断——岗位制必须破。
逻辑很简单:
- 碳基时代分工是效率提升,因为人精力有限、深耕一个岗位才能做精
-
AI 时代分割反而是效率丧失,因为 AI 已经能补上"你不会的能力"
公式变成了:
人才价值 = 你具备的核心判断力 × AI 能补上的所有外延能力
如果你只是"会做产品但不懂技术",AI 时代你就被压缩成"只会做产品";如果你是"懂技术 + AI 给你补产品视角",你的价值反而被放大成"研发 + 产品双跨"。**两个'懂'叠加,才是 AI 时代的护城河**。
我们在内部的具体落地是:研发负责人主导核心产品页面的设计;运营自己用 AI 跑数据分析;产品经理自己写 PRD 拆 Jira。
每一个原本"必须找别人翻译一下"的环节,AI 都把那个"翻译"动作整体接管了。当翻译层减少,组织就会变薄;当组织变薄,真正有判断力的人会浮上来。
六、AI 实习生计划:用零基础,验证组织变革的可行性
讲了那么多机制,最有说服力的还是真实数据。
CSDN 这个月做了一个非常激进的实验,叫 AI 实习生计划——招了 5 位完全不同专业背景的高校实习生(工商管理、计算机本科、生物医学工程、计算机大四、文科本科),3 周到 40 天后,他们独立交付了 20 多个企业级产品,覆盖法务、运营、视频、HR、企服几乎所有非技术岗位。
带队人是闫辉,他产品经理出身,现在已写了 200 多个程序,现在职务是首席 Skill 官。这个实验要验证的是——一个零基础的人,在正确的方法论下,能不能像一家"一人公司"那样,用 AI 独立交付企业级成果?
闫辉的方法论:两条铁律 + 三层认知
闫辉给这 5 位实习生定了两条铁律——这是 AI 时代零基础新人最短的入门路径:
铁律一 · 绝对执行:任何交给你的任务,先相信 AI 能做到。一旦觉得"这任务太难 AI 做不了",你就不会尝试;不尝试,永远不知道边界在哪。
铁律二 · 杠杆检索:不要从零造轮子。要去 GitHub 找、去 Skill Library 找——**碳基时代的高手是从零造轮子的人;硅基时代的高手是能从全世界已有的轮子里找到该拼装的那 3 个的人**。
在两条铁律之上,实习生们走过一个三层认知跃迁:Trust(敢用)→ Retrieve(会找)→ Assemble(能拼) 。每一层都有一个心理障碍要跨过——信任层跨不过去,永远停留在"AI 只能写 Hello World"的误判里;检索层跨不过去,会在"从零写"上浪费 80% 时间;组装层跨不过去,做出的就是一堆孤立的小 Skill,永远拼不成产品。
实验节奏极其简单——隔天交替:1 天学新工具/资讯 + 1 天项目汇报/指导。纯项目驱动,零理论授课。这就是 Diana 讲的"每个人都是 IC,带可工作的原型来开会"的中国版本。
跨部门赋能矩阵:6 类产品全部由零基础新人交付
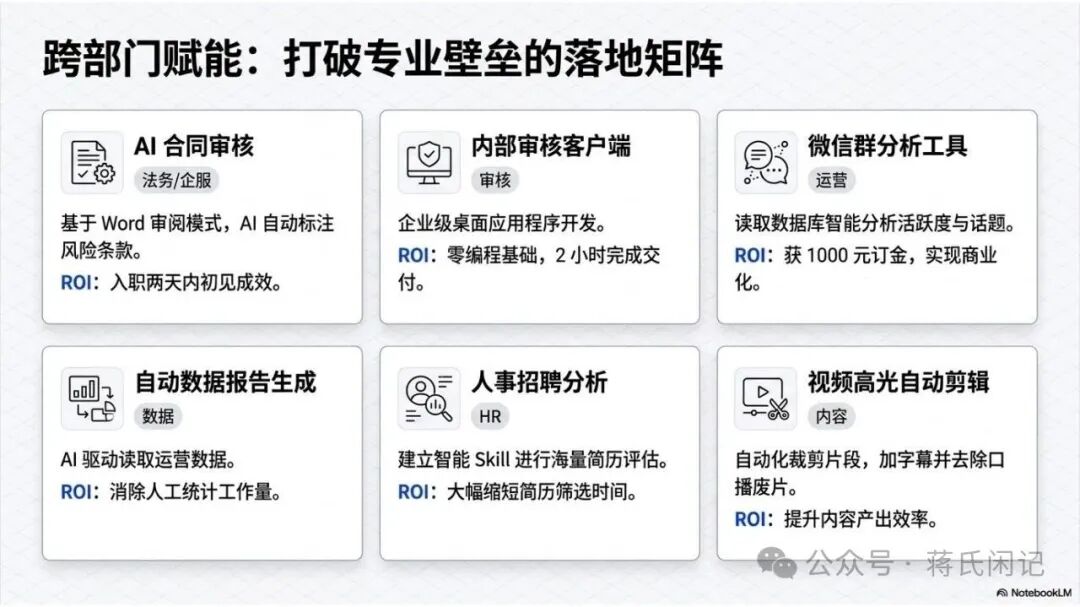
跨部门赋能:打破专业壁垒的落地矩阵
3 周到 40 天后,5 位实习生交付的产品矩阵覆盖了几乎所有非技术岗位——法务(合同审核)、审核(内部客户端)、运营(群分析)、数据(自动报告)、HR(简历评估)、内容(视频高光剪辑) 。其中合同审核入职两天初见成效;内部审核客户端零编程基础 2 小时交付;微信群分析工具已获 1000 元订金。
这张矩阵图回答了一个最关键的问题——AI 原生组织里,"非技术岗位"还有没有专门存在的必要?
答案已经在矩阵里:这些过去需要 6 个独立部门的事,被 5 个零基础实习生在 3 周里全部跑通了。
值得一提的是,5 位实习生的产品里还有一些非常具有"AI 原生"特色的形态创新——比如把 AI Agent 平台塞进 U 盘、即插即用:
A
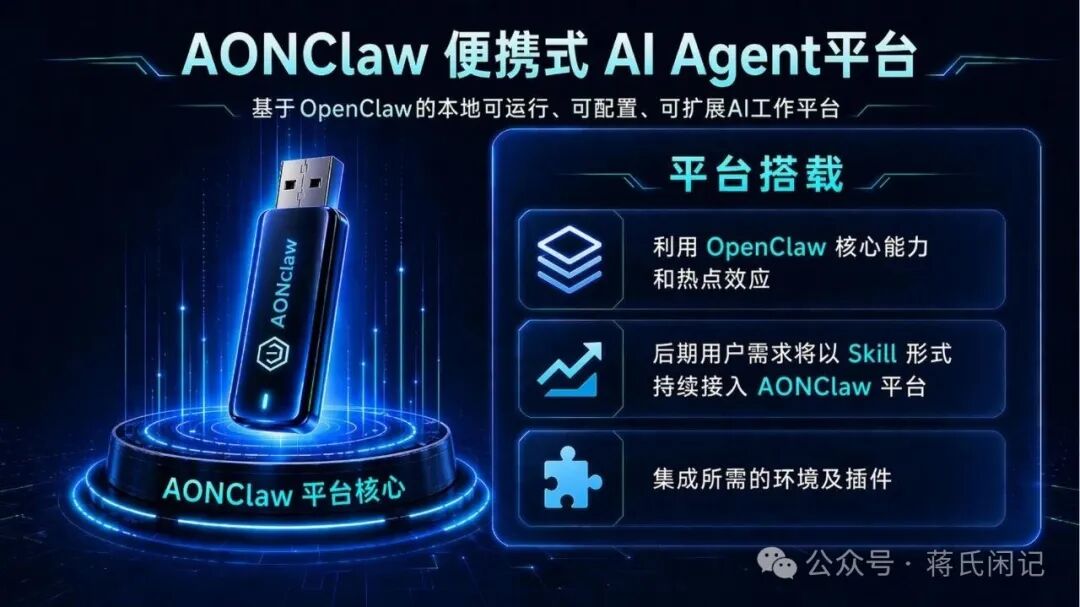
AONClaw 便携式 AI Agent 平台
这背后是一个重要的产品哲学:AI 原生产品的核心竞争点,不是 AI 多厉害,而是用户门槛多低。同样的 Agent 能力,是让用户自己装,还是插上 U 盘就用——决定了它能触达多大的人群。
下面挑 3 个最有代表性的案例,把"实习生本人的反思"这一层补全。
案例一:工商管理研究生 × 法务——三步循环法
第一位是工商管理专业的研二学生。1 个月内她独立交付了一个完全跨专业的法务系统——AI 自动识别合同风险(高/中/低)、输出 WPS 修订格式、一键修订。这个系统在业务里自己进化出了三个子产品——从法务用,扩展到销售用作"案例学习",再扩展到业务做"模板新建"。
一个没做过法律的研究生,怎么做到的?她自己提炼出"AI 赋能三步循环法"——学领域 → 接真实数据 → 做诊断。
她的反思最值得带走的是这一句:
"我能做什么?回答是几乎都可以完成。但是能做什么,不代表能否做好。"
紧跟着她描述了自己 4 周内的角色跃迁:第一周是创作者,第二三周是控制者,第四周是审查者。
一个研二学生在 3-4 周之内,把资深职业经理人需要 5-10 年的跃迁路径走完了——不是因为她聪明,是因为 AI 把"执行"压到几乎为零,她被直接推到了"控制和审查"的位置。
案例二:生物医学工程研究生 × 桌面应用——六维反思
第二位是生物医学工程专业的研究生——3 周前完全不懂前端——3 周后她独立交付了一个桌面级群聊智能分析客户端"群小猴 ChatLens",技术栈包含 7 种框架;外加一个公众号软文监测系统。两个产品都跑出商业化闭环——分别拿到 1000 元和 500 元订金。
她最有价值的产出是 6 个维度的反思——这是我看到的对 AI 时代工程实践最完整的归纳之一:
开发效率:AI 秒级生成样板代码,速度提升 3-5 倍
调试方式:把报错粘给 AI,省去大量搜索时间
学习路径:从"先学再做"变成**"边做边学"**
交付标准:从"交报告即可"到"真实可用的安装包 + 文档 + 维护"
代码质量:AI 生成的不一定最优,需要开发者有判断力 review
思维能力:AI 降低了实现门槛,但对架构和拆解的要求更高——你要知道"问什么"才能得到好答案
最后一条值得专门强调——**"你要知道'问什么'才能得到好答案"**。这就是 Diana 讲的"对话质量决定价值"在一个 3 周前还不会前端的研究生身上的具体落地。
她还讲过一段非常打动我的话:
"我们可以让 AI 自己跑这个项目,让它自己测试一遍流程,让它自己发现问题、自己修改。"
注意主语从"我"变成了"AI"——一个非工程背景的人,3 周内自然把自己从 Do-er 升级成了 Orchestrator。
案例三:计算机大四学生 × 视频剪辑——四句留下来的体会
第三位是计算机专业的大四学生。他做了一个 AI 驱动的视频高光自动剪辑工具 Highlight 高光捕手——把原本一星期才能剪完的两小时大会视频,压缩到一次按键。
他把方法论提炼成"四句留下来的体会",几乎可以印在 AI 时代工程教材的扉页上:
1. 从想法到落地:AI 让没有技术背景的人也能把想法变成真实产品
2. 光学不够,要上手:把"知道"推到"做到"
3. 版本管理 · 迭代思维:从最小闭环 MVP 起步,按真实需求迭代
4. 产品闭环 · 会讲价值:好产品也要自己会说话
他还有一句最扎心的工程反思:**"工程能力的上限,取决于你设计 Harness 的能力,而不是写代码的速度。" ——一个大四学生已经自发走到了这个认知: 写代码已经不是稀缺能力,设计"让 AI 能持续正确工作的系统"才是**。
闫辉自己的反思:从代工厂到火车头
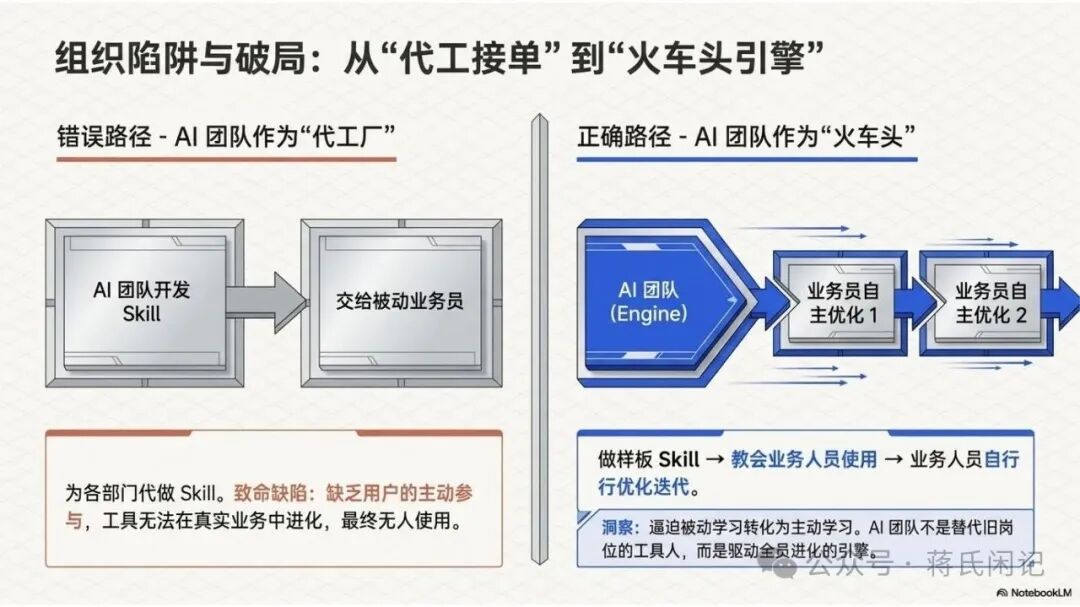
组织陷阱与破局:从代工接单到火车头引擎
讲完案例,闫辉自己有一个很深的反思——关乎 AI 团队该怎么和业务部门协作。
错误路径是 AI 团队作为"代工厂"——业务提需求、AI 团队帮做。闫辉讲得很狠:**"你帮他做了,只解决了一个小痛点,他有可能反而不会用。对普通员工讲 AI,他有巨大的恐惧感——因为当我做到那一刻,他的职位就没有价值了。"** 这是组织转型里一堵真实的人性墙。
正确路径是 AI 团队作为"火车头引擎"——做样板 Skill,教会业务人员使用,让他们自行迭代。
闫辉举的例子很打动我:"有个同事要做报告,我们告诉他怎么用 Claude Code 读取数据。读完之后他再也没找过我们——因为我教会给他、对他有用,他自己去学。"关键差别:**他不是被动接受了一份 AI 报告,而是学会了"用 AI 生成报告的能力"**——前者是一次性服务,后者是永久性赋能。
由此闫辉给出三条结论——AI 转型必须由 leader 驱动:因为 leader 看到的是"整条工作流"、员工看到的只是"自己这一段动作",**优化一个动作只是省时间,重写一条流程才是生产力跃迁; 最佳实践要强制投喂 ,克服员工自发学习的人性弱点; Token 必须给够 ——这跟 Diana 反复强调的 Token Maxing 是同一件事。这就回到了 Diana 讲的"AI Founder type 必须是创始人本人"—— 创始人不能把 AI 战略外包**。
七、逆向洞察:当生产无限廉价,什么变贵了?
讲到这里你可能会觉得 AI 时代是"什么都便宜、什么都快"——那人的价值会归零吗?
恰恰相反。当硅基时间让生产变得无限廉价时,另外一些东西变得空前昂贵。
第一,架构审美变贵了。 三人不会 Rust 的小队能半个月重写 Claude Code,不是因为他们打字快——是因为他们能在开始前把架构想清楚。这种"架构审美"是碳基时代无数项目失败的经验蒸馏出来的,**AI 学不会,因为它没有过"失败的痛"**。
第二,判断密度变贵了。 Diana 演讲里有句扎心判断:有了 AI 之后,公司能用小得多的团队拿到超大的结果。YC 社群里给这件事的极限表达叫** "单人独角兽"(One Person Unicorn)——一个人把所有过程底表化、再 Agent 化,意图被无限并行放大。 未来的竞争不是看谁人多,而是看谁能在单位碳基时间内并行调度最多的硅基算力 。但这件事的另一面是—— 留下来的每一个人都必须是高判断力密度的个体**;一个没有判断力的人在 AI 时代价值是负的。
第三,对自己的要求变贵了。 内部有一次会上,我讲过一个真实见闻:一个 9 岁孩子用 AI 做动画,水准已经到了准专业级别。他爸爸说,这孩子有件事很特别——他用 AI 生成那只动画里的猫,一定要调到跟自己家养的那只猫几乎一模一样。一只 AI 生成的猫他可以一分钟搞完,但他选择了调到半夜。不是有人要求他,只是因为那是他家的猫。
这个故事是整套 AI 原生方法论的题眼。
我们前面讲的所有机制——底表化、AI 评估、Token Maxing、DRRI、岗位制要破——它们都是机制层面的。**但机制只能筛掉摸鱼选手,它筛不出"卓越"**。
机制保下限,追求决定上限。 一分钟生成的猫和调到半夜的猫,在 AI 时代成本几乎一样,但呈现出来的品质天差地别。这就是 AI 时代"专业主义"的全部本质。
八、扎心三问
Diana 在演讲结尾说,早期创业公司在这场转变中拥有巨大优势——没有遗留系统、没有组织结构图惯性、没有数千人的再培训成本,可以从第一天就把公司围绕 AI 构建。相反,大公司必须在维护现有产品的同时解开多年的标准操作程序——对核心流程的每一次改变,都有破坏已经运作良好东西的风险。
她原话:**"AI native 不是未来,它已经是现在。问题只是你的公司准备好了吗?"**
我把这个问题再具体化,送给你三问:
问题一:你公司有没有一个"AI 总管",自己读公司里所有的人和事?
不是 Copilot,不是聊天机器人,不是某个员工桌面上装了个工具。
我说的是:一个 AI Agent,自己默默读你团队的工单、commit、客户反馈、销售记录、Slack 讨论;上周做了什么、客户为什么投诉、下周该把谁的优先级排到前面——它都比你清楚。每周开会前你看它给的报告,比看每个人的周报还省心。
如果没有,你就还在用人传话——**信息每经过一层人就丢一次;过 5 层之后,已经丢了 80%**。
问题二:你的工作过程是底表,还是叙述?
碳基时代过程是叙述——周报、汇报、纪要,信息丢失大半;硅基时代过程是数据——commit、Jira、对话记录、Token 消耗。如果你的核心管理动作还停留在"开会问大家本周做了什么",你还在开环里。
问题三:你的考核还是"工时 × 人数",还是"调度的硅基时间 × 并行系数"?
这一问最锋利。它直接对应 Diana 讲的"token maxing 取代 headcount maxing"。前者衡量投入,后者衡量真实产能——两者在 AI 时代差着两个数量级。
如果三个问题答案都是"还没"——那你的组织仍然是一家碳基公司。碳基公司在硅基原生公司面前不是被打败,而是被维度降维——就像马车在汽车面前,不是跑得慢,是不在同一条赛道。
5 位高校实习生用 3 周验证了能做,3 个不会 Rust 的工程师用半个月验证了能做,YC 投出去的几十家硅谷创业公司正在用 sprint 减半 + 产出 10 倍验证能做。
未来的公司,不是人力堆出来的,而是被硅基时间调度出来的。
剩下的问题只有一个:**你什么时候开始? **
一个邀请:建一个 AI CEO 群
写到这里,我也想跟读这篇文章的同行们说一件事——
AI 时代的 CEO,必须亲临第一线,才有体感。技术演进太快,光看二手解读和报告远远不够;如何把 AI 真正用好,需要不断实践、不断踩坑、不断和同行交换经验。
所以我准备建一个 AI CEO 群,给那些愿意亲手干、愿意把公司围绕 AI 重新设计的创始人和一号位(OPC)一个长期切磋的地方。
第一期计划在 5 月中旬,于北京线下交流。如果你正在推动公司的 AI 原生转型、有具体的踩坑或心得想分享,
入群方式:在本公众号后台回复关键词 "AI CEO" ,会有提示如何加入(备注"AI CEO 群+公司+姓名")。
//作者手记
本文双源印证:Y Combinator 合伙人 Diana Hu 于 2026 年 4 月在 YC Startup School 的演讲《How To Build A Company With AI From The Ground Up》,以及 CSDN 内部 2026 年 4 月的三场闭门会议(产研策略会、产研流程优化专项会、AI 实习生汇报会)。我相信两个独立来源在同一周得出几乎相同的判断,本身就是这场范式转移真实性的最强证据。
关于数据:文中"AI 代码生成率 86.2%"、"测试 bug 数 186→62"、"一周 Token 消耗 2 万元"等数据,均为 CSDN 内部某个核心 AI 项目截至 2026 年 4 月的阶段性统计,仅用于趋势说明、不代表全公司平均水平。
AI 时代,企业竞争的基本单位,正在从人,迁移到时间。
硅基时间 · 目录
#硅基时间
上一篇硅基时间:20亿美元年收入,GitHub用了5500人,Cursor 150人,Claude Code 只有 12 人下一篇硅基时间万字长文答问录(一):码盲消失,OPD 崛起,新市场在哪里